
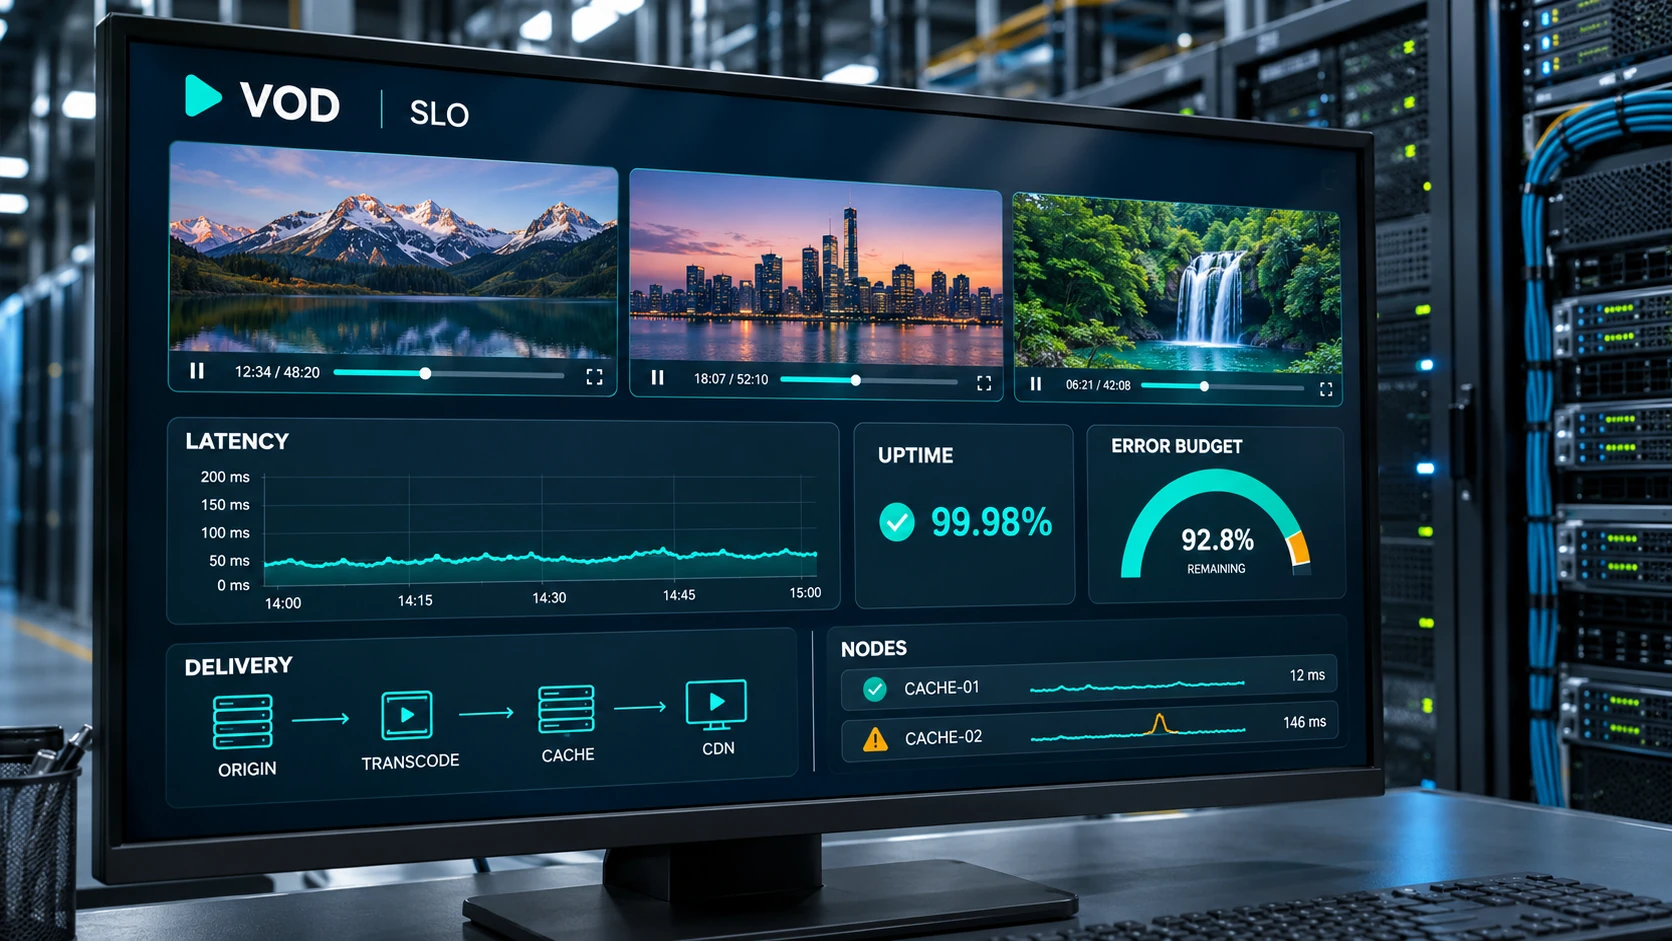
مانیتورینگ و SLO در VOD باید نشان دهد کاربر میتواند ویدئو را شروع کند و بدون توقف آزاردهنده تماشا کند؛ سالمبودن پردازنده و پاسخگویی API بهتنهایی کافی نیست. این مقاله برای تیم دواپس، SRE و مدیر محصول نوشته شده و از تعریف شاخص تجربه پخش تا بودجه خطا و تصمیم انتشار نسخه را پوشش میدهد.
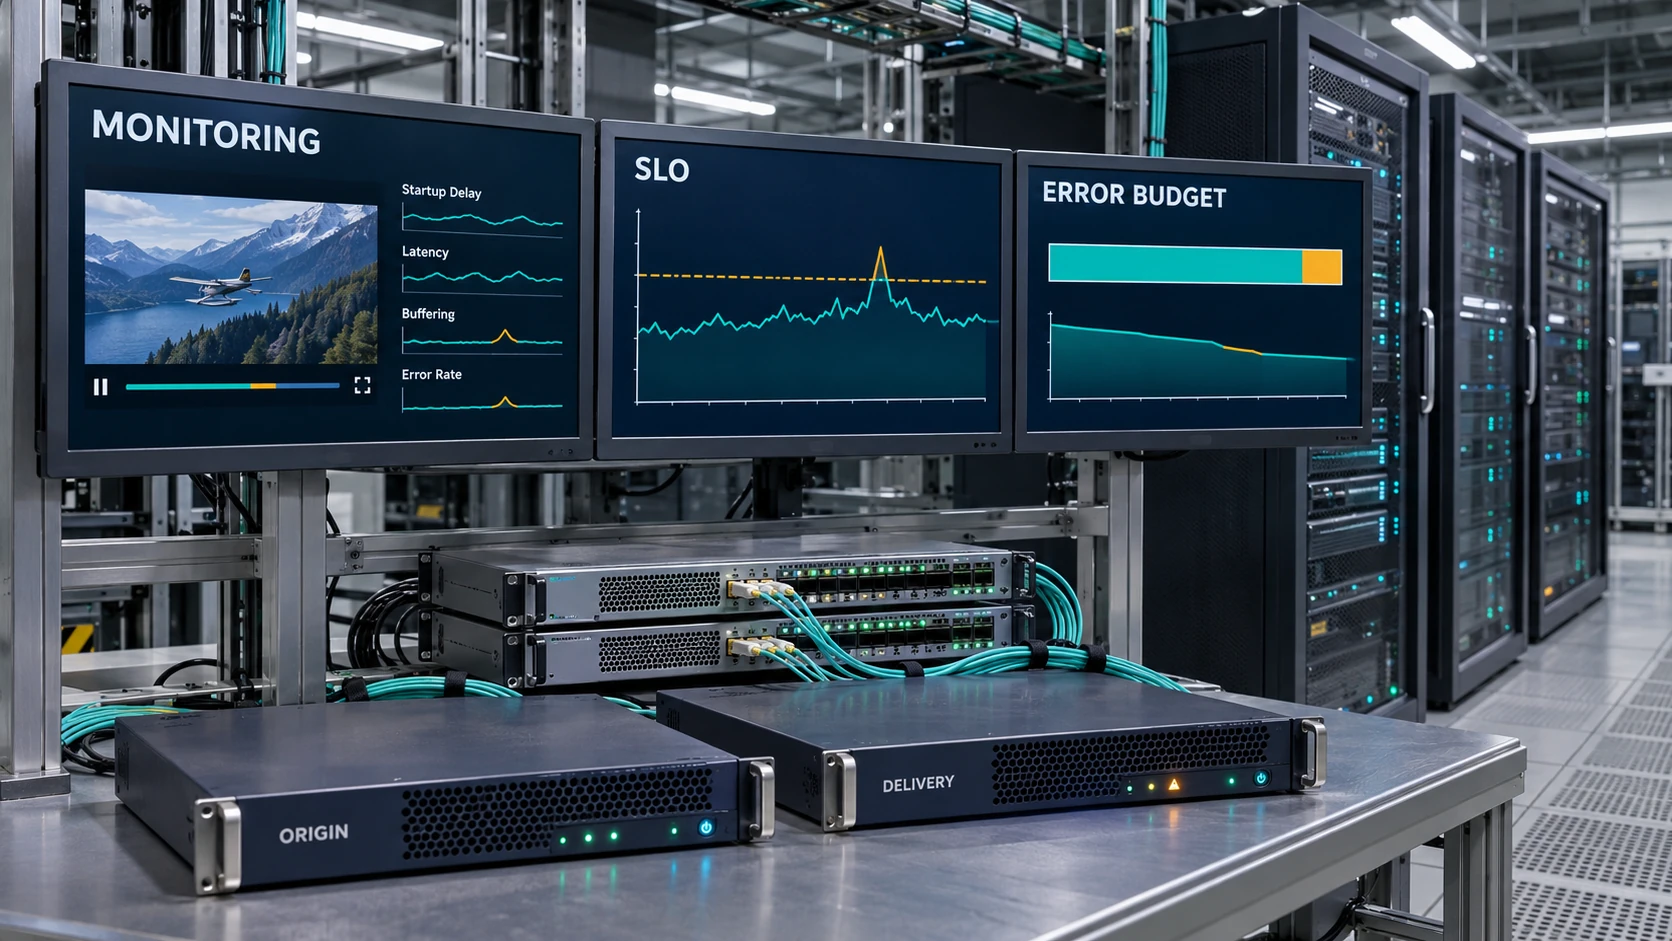
موضوع این مقاله، ارتباط Monitoring، SLO و Error Budget در پلتفرم VOD است: Monitoring وضعیت و تجربه پخش را اندازه میگیرد، SLO سطح کیفیت مورد انتظار را مشخص میکند و Error Budget مبنای تصمیم درباره ریسک انتشار و اولویت پایداری میشود. این سه بخش باید یک قرارداد قابلآزمون بین محصول و عملیات بسازند.
تفاوت Monitoring، SLI، SLO و Error Budget
مانیتورینگ، دادههای رفتار سامانه را جمعآوری و نمایش میدهد. SLI شاخص قابلاندازهگیری کیفیت خدمت است؛ مانند سهم تلاشهایی که واقعاً به اولین فریم رسیدهاند. SLO هدف همان شاخص در یک بازه مشخص است. Error Budget یا بودجه خطا، مقدار شکست مجاز در چارچوب آن هدف است. SLA نیز توافق خدمت با پیامدهای قراردادی است و نباید با هدف داخلی تیم یکسان فرض شود.
در مانیتورینگ و SLO در VOD، سبزبودن سرورها پاسخ نهایی نیست. ممکن است API سالم باشد اما گواهی CDN، فایل Manifest یا سرویس DRM مانع پخش شود. بنابراین ابتدا «کار موفق کاربر» را تعریف کنید و سپس منابع زیرساختی مؤثر بر آن را پایش کنید. چارچوب پیادهسازی SLO در Google SRE نیز هدف خدمت را ابزار تصمیمگیری مشترک محصول و عملیات معرفی میکند.
برای شناخت وابستگیها، راهنمای معماری زیرساخت VOD را مبنای ترسیم مسیر کاتالوگ، مجوز، CDN، Origin و ذخیرهسازی قرار دهید.
شاخصها را از مسیر واقعی تماشای ویدئو انتخاب کنید
در مانیتورینگ و SLO در VOD، شروع پخش، تداوم تماشا و جابهجایی در ویدئو تجربههای متفاوتی هستند. همه آنها را در یک میانگین پنهان نکنید. جدول زیر الگوی پیشنهادی طراحی شاخص است، نه استاندارد اجباری صنعت.
| تجربه | SLI پیشنهادی | نکته اندازهگیری |
|---|---|---|
| شروع پخش | تلاشهای واجد شرایط با اولین فریم در مهلت مشخص ÷ کل تلاشهای واجد شرایط | Timeout و خطای نهایی نیز باید نتیجه ثبتشده داشته باشند |
| سرعت آغاز | سهم شروعهای موفق زیر آستانه زمانی | زمان آغاز را از فرمان پخش تا اولین فریم تعریف کنید |
| تداوم تماشا | سهم نشستهای دارای نسبت توقف کمتر از حد توافقشده | توقف ارادی کاربر را از Buffering جدا کنید |
| Seek | جابهجاییهای موفق با بازگشت تصویر در مهلت تعیینشده | سیاست Seekهای پیاپی و لغوشده روشن باشد |
| آمادهسازی محتوا | کارهای معتبر منتشرشده پیش از مهلت ÷ کل کارهای معتبر سررسیدشده | برای طول و کیفیتهای مختلف ویدئو کلاس جدا تعریف کنید |
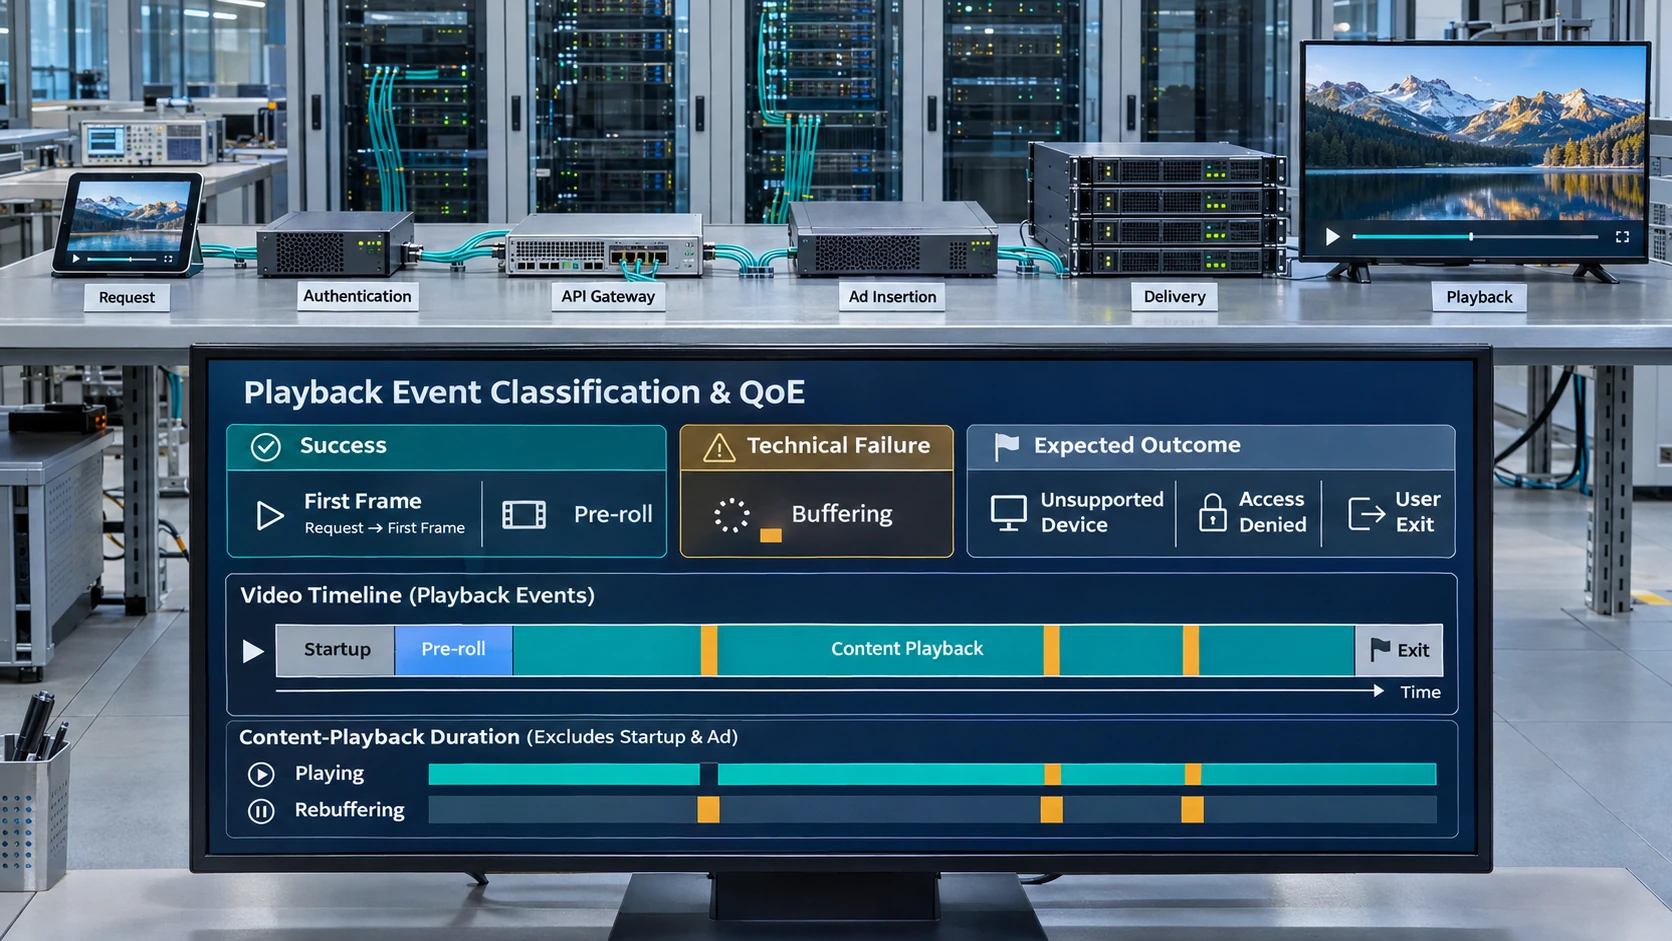
در قرارداد مانیتورینگ و SLO در VOD مشخص کنید تبلیغ پیش از ویدئو، پخش خودکار، دستگاه پشتیبانینشده، نبود حق دسترسی و خروج زودهنگام کاربر چگونه دستهبندی میشوند. خروج قبل از اولین فریم را بیدلیل موفق حساب نکنید؛ ممکن است نشانه انتظار طولانی باشد. در مقابل، مسدودشدن صحیح یک کاربر فاقد مجوز، لزوماً خرابی فنی نیست.
برای نسبت Buffering میتوانید زمان توقف ناخواسته را بر مجموع زمان پخش واقعی و همان توقفها تقسیم کنید. این یک تعریف داخلی پیشنهادی است؛ شروع اولیه، Pause و Seek را جدا نگه دارید. قبل از مقایسه با ابزار دیگر، مخرج و محدوده زمانی آن را بررسی کنید؛ تعریف شاخصهای Mux Data نشان میدهد اصطلاحات ظاهراً مشابه به قرارداد اندازهگیری وابستهاند.
معماری جمعآوری داده از پلیر تا زیرساخت
مانیتورینگ و SLO در VOD به سه منبع مکمل نیاز دارد: رویدادهای واقعی پلیر، آزمون مصنوعی مسیر پخش و تلهمتری سمت سرور. اولی تجربه مشاهدهشده کاربر را گزارش میدهد؛ دومی بدون انتظار برای شکایت کاربر مسیر مشخصی را میآزماید؛ سومی به پیدا کردن علت کمک میکند.
- پلیر: درخواست شروع، اولین فریم، آغاز و پایان توقف، Seek، خطای نهایی و پایان نشست.
- آزمون مصنوعی: ورود مجاز، دریافت Manifest و Segment و در صورت نیاز مجوز DRM از چند شبکه یا منطقه.
- زیرساخت: نرخ خطا، زمان پاسخ، اشباع، Cache Hit، وضعیت Origin، صف تبدیل و سلامت ذخیرهساز.
برای رویدادها شناسه یکتا، نسخه طرح، زمان رخداد و زمان دریافت ثبت کنید. زمانهای نسبی پلیر را با ساعت یکنواخت همان دستگاه بسنجید؛ تفریق مستقیم ساعت کلاینت و سرور ممکن است خطای همگامسازی داشته باشد. یک تجمیعگر باید Retry ارسال را حذف تکراری کند و هر تلاش پخش را طبق یک قاعده ثابت نهایی کند.
شناسه نشست و کاربر را برچسب متریک Prometheus نکنید. آنها را، در صورت نیاز و با حداقل داده شخصی، در لاگ یا مخزن رویداد دارای کنترل دسترسی نگه دارید. برچسبهای کمتنوع مانند کلاس دستگاه، منطقه محدود و CDN برای متریک مناسبترند. ترکیب تعداد زیاد نسخهها و کیفیتها نیز میتواند تعداد سریها را شدیداً افزایش دهد.
اعتبار مانیتورینگ و SLO در VOD به سلامت سامانه دریافت رویداد وابسته است؛ اختلال این سامانه نباید نمودار کیفیت را بهاشتباه بهتر کند. تأخیر ورود داده، رویدادهای رهاشده و پوشش تلهمتری را مستقل نمایش دهید. نبود داده، موفقیت نیست. نتیجه نمونهبرداری نامتوازن یا ثبت صرفاً نشستهای پایانیافته نیز میتواند خطاهای شدید را کمشمارش کند.
تعریف هدف و بازه برای مانیتورینگ و SLO در VOD
برای تعیین اهداف مانیتورینگ و SLO در VOD، ابتدا خط پایهای شامل ساعت پرترافیک، انتشار نسخه جدید و چند گروه دستگاه جمعآوری کنید. سپس محصول و SRE بر اساس حساسیت تجربه، توان مهندسی و هزینه درباره هدف توافق کنند. عددی مانند ۹۹٫۹٪ بدون تعریف جامعه، زمان و منبع داده قابل اجرا نیست.
نمونه آموزشی SLO شروع پخش: در پنجره لغزان ۳۰روزه، حداقل ۹۹٫۵٪ تلاشهای واجد شرایط، روی نسخههای پشتیبانیشده پلیر، حداکثر در ۱۰ ثانیه به اولین فریم برسند. واحد شمارش یک تلاش منطقی پخش است؛ Retry داخلی همان تلاش، مشاهده جدید ایجاد نمیکند. این اعداد فرضیاند و توصیه عمومی یا SLA آوابرید نیستند.
میتوانید در کنار آن، هدف مستقلی برای «شروع سریع زیر ۳ ثانیه» داشته باشید. شکست شروع را از شاخص سرعت که فقط شروعهای موفق را میسنجد حذف کرده و بعد آن شاخص را بهعنوان موفقیت کل ارائه نکنید؛ هر دو باید کنار هم دیده شوند. برای پردازش و انتشار محتوای جدید نیز SLO جدا لازم است تا طول صف Transcoding با کیفیت پخش آرشیو مخلوط نشود.
سند مانیتورینگ و SLO در VOD باید برای هر هدف، مالک، صورت و مخرج، استثناها، آستانه، پنجره، تأخیر نهاییشدن داده و اقدام هنگام نقض را مشخص کند. اگر برای یک تلویزیون یا شبکه خاص مشکل وجود دارد، نرخ کلی سالم نباید آن را پنهان کند. نمونه کم را با تعداد مشاهده و محدودیت اطمینان گزارش کنید.
محاسبه Error Budget با مثال روشن
برای SLO مبتنی بر رویداد، بودجه را با تعداد رویداد حساب کنید. تبدیل مستقیم آن به دقیقه قطعی تنها برای مدل زمانی مناسب است؛ اختلال کوتاه در ساعت اوج ممکن است تعداد زیادی تلاش پخش را خراب کند.
نسبت خطای مجاز = ۱ − هدف SLO
تعداد خطای مجاز = تعداد تلاشهای واجد شرایط × نسبت خطای مجاز
بودجه باقیمانده = تعداد خطای مجاز − تعداد تلاشهای ناموفق
در مثال آموزشی، اگر یک میلیون تلاش واجد شرایط داشته باشیم و هدف ۹۹٫۵٪ باشد، بودجه برابر ۵۰۰۰ تلاش ناموفق است. با ۳۰۰۰ شکست، ۶۰٪ بودجه مصرف شده و ۲۰۰۰ تلاش باقی مانده است. اگر شکستها به ۶۰۰۰ برسند، مصرف به ۱۲۰٪ میرسد و بودجه ۱۰۰۰ تلاش کسری دارد.
در مانیتورینگ و SLO در VOD، بودجه هر هدف را جدا گزارش کنید. بودجه خوب شروع پخش نباید نقض هدف توقف حین تماشا را بپوشاند. در پنجره لغزان نیز با خروج رویدادهای قدیمی و ورود ترافیک جدید، صورت و مخرج تغییر میکنند؛ موجودی بودجه یک حساب ثابت ماهانه نیست.
روش رویدادمحور و نقش سیاست تصمیمگیری را میتوانید در نمونه سیاست بودجه خطای Google SRE دنبال کنید. سیاست داخلی شما باید متناسب با محصول نوشته شود.
هشدار بر اساس Burn Rate و چند پنجره زمانی
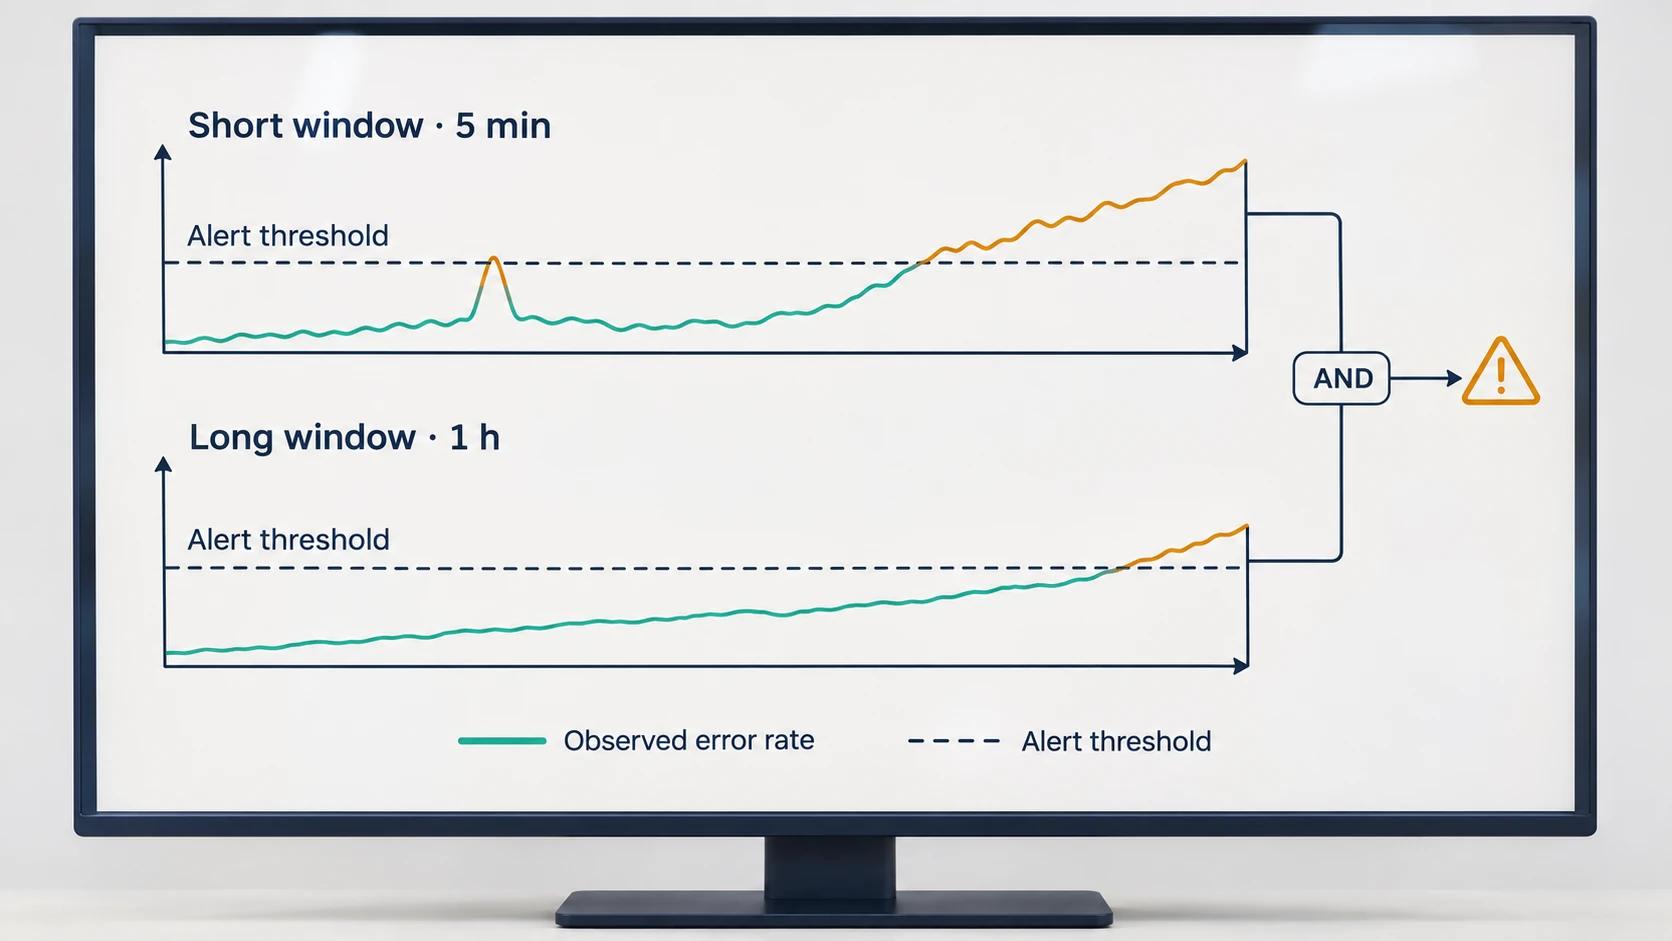
Burn Rate نسبت نرخ خطای مشاهدهشده به نرخ خطای مجاز است. با هدف ۹۹٫۵٪، نرخ مجاز ۰٫۵٪ خواهد بود؛ نرخ خطای ۲٪ یعنی Burn Rate برابر ۴. این عدد شدت مصرف را نشان میدهد؛ زمان دقیق تمامشدن بودجه در ترافیک متغیر به حجم آینده و وضعیت پنجره هم وابسته است.
برای مانیتورینگ و SLO در VOD، هشدار کوتاهمدت را با یک پنجره بلندتر تأیید کنید. در الگوی آموزشی ۳۰روزه Google SRE، عبور همزمان Burn Rate از ۱۴٫۴ در یک ساعت و پنج دقیقه، یا عبور همزمان از ۶ در شش ساعت و سی دقیقه، نمونه هشدار فوری است. این مقادیر را بدون بازبینی حجم ترافیک، تأخیر تلهمتری و ظرفیت پاسخگویی کپی نکنید. منبع: هشداردهی مبتنی بر SLO.
در ترافیک کم، یک شکست میتواند نسبت بزرگی ایجاد کند. حداقل تعداد مشاهده را آگاهانه انتخاب کنید و همزمان آزمون مصنوعی یا هشدار قطع کامل داشته باشید تا حذف هشدارهای کمنمونه، خرابی واقعی را مخفی نکند. برای قطع تلهمتری نیز هشدار جدا لازم است.
هر هشدار باید نام هدف، گروه متأثر، تعداد تلاشها، نرخ خطا، پنجره، نسخه اخیر، مالک و پیوند دستورالعمل بررسی را همراه داشته باشد. هشدار CPU بالا میتواند برای پیشگیری مفید باشد، اما معادل نقض تجربه کاربر نیست.
نمونه متریک و محاسبه در Prometheus
در این نمونه از پیادهسازی مانیتورینگ و SLO در VOD، تجمیعگر قابلاعتماد برای هر تلاش نهاییشده فقط یکبار شمارنده vod_playback_attempts_total را با نتیجه good یا bad افزایش میدهد. تصمیم موفق یا ناموفق شامل مهلت شروع پخش است. متریک خام HTTP جای این شمارنده را نمیگیرد. کد زیر نمونه آموزشی PromQL است و باید با نامها و مدل داده واقعی تطبیق داده شود.
sum(rate(vod_playback_attempts_total{result="bad"}[5m]))
/
sum(rate(vod_playback_attempts_total[5m]))
برای هدف فرضی ۹۹٫۵٪، خروجی عبارت بالا را بر ۰.۰۰۵ تقسیم کنید تا Burn Rate پنجدقیقهای به دست آید. پنجرههای دیگر را با همان فیلتر و جامعه بسازید. هنگام صفر بودن مخرج یا غیبت داده، وضعیت را نامعلوم یا بدون ترافیک نشان دهید؛ آن را خودکار به موفقیت کامل تبدیل نکنید.
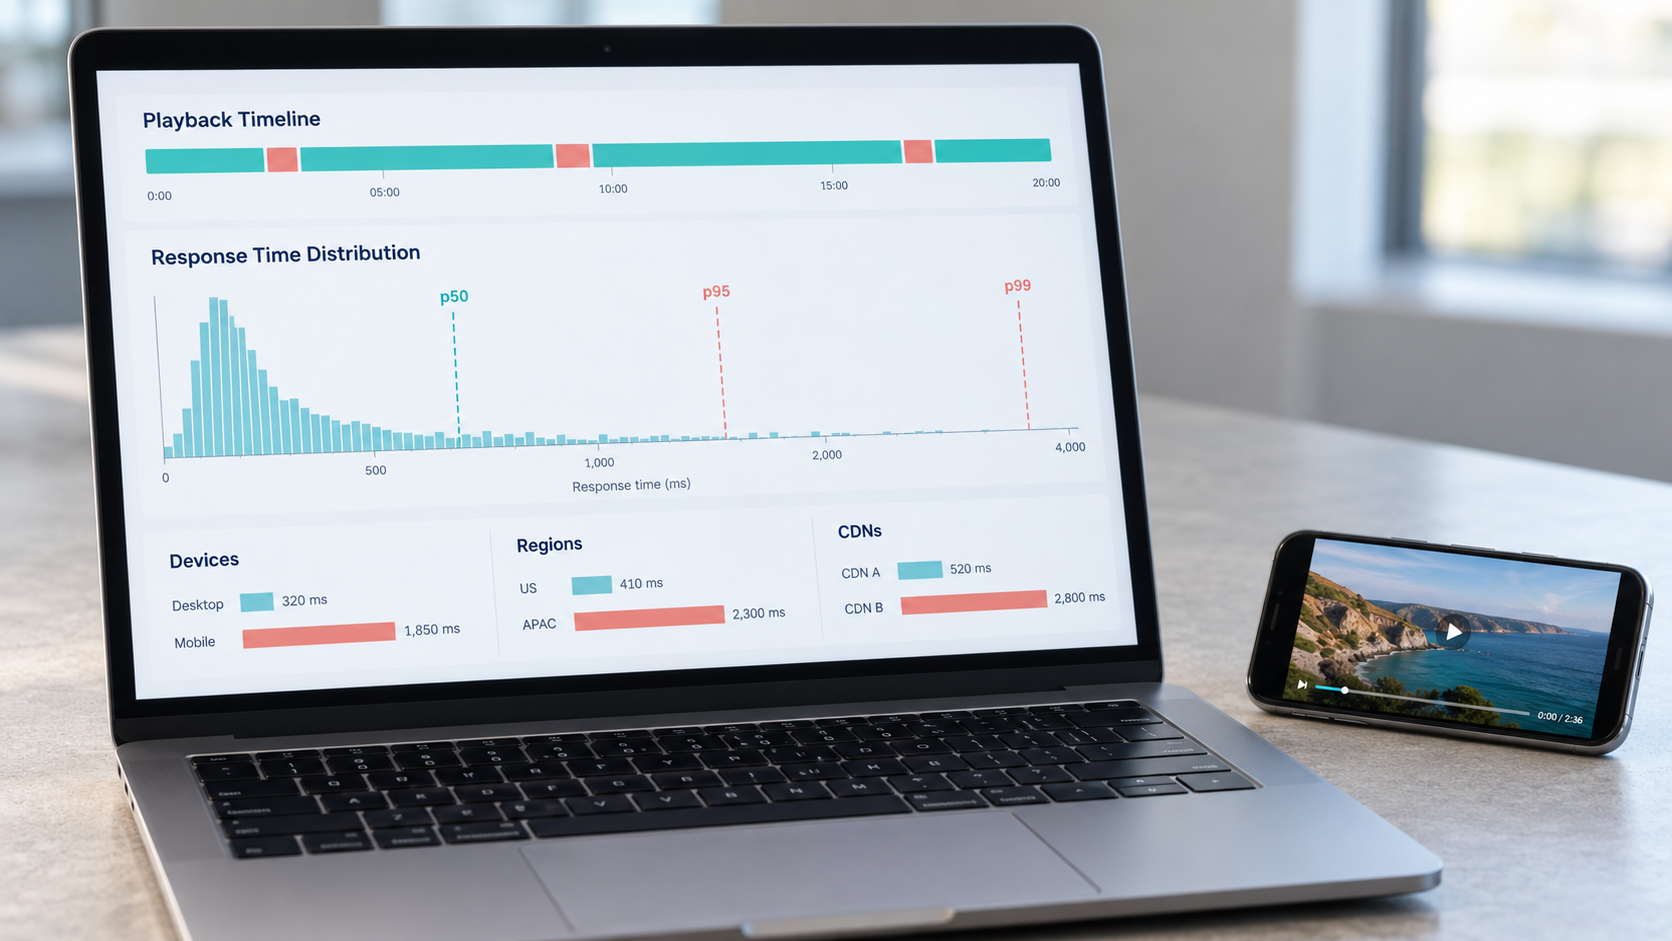
برای تأخیر از Histogram با مرز مناسب نزدیک آستانه SLO استفاده کنید. p95 یک نود را با p95 نود دیگر میانگین نگیرید؛ ابتدا توزیع سازگار را تجمیع و سپس صدک را محاسبه کنید. مستندات Histogram و Summary در Prometheus تفاوت محاسبه و تجمیع آنها را توضیح میدهد.
در طراحی مانیتورینگ و SLO در VOD، صدکها برای تشخیص کندی مفیدند، اما برای بودجه معمولاً نسبت رویداد خوب به کل شفافتر است. درصد موفقیت گروهها را نیز بدون وزن میانگین نگیرید؛ مجموع صورتها را بر مجموع مخرجها تقسیم کنید.
داشبوردی که به تصمیم عملیاتی برسد
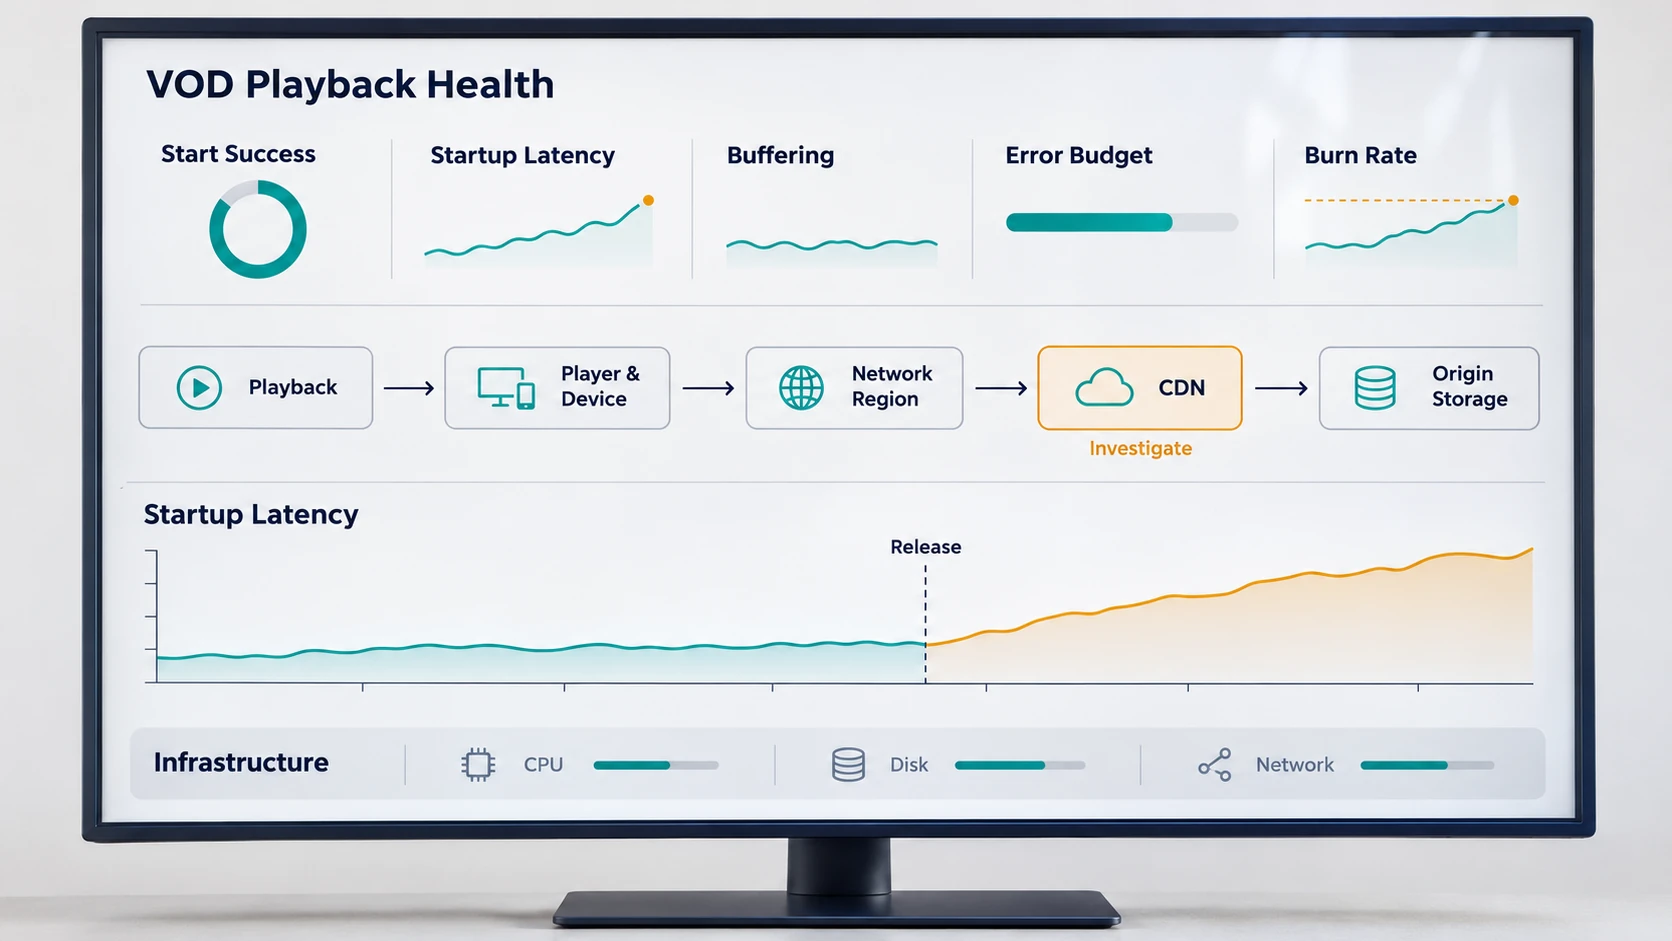
نمای اول داشبورد مانیتورینگ و SLO در VOD را به موفقیت شروع، سرعت آغاز، توقف پخش، بودجه باقیمانده و Burn Rate اختصاص دهید. کنار هر مقدار، بازه و تعداد نمونه را نمایش دهید. نمودارهای CPU، دیسک و شبکه در نمای تشخیص علت قرار میگیرند. نشانگر استقرار نسخه و تغییر پیکربندی نیز ارتباط زمانی مشکلات را آشکار میکند.
مسیر بررسی پیشنهادی: ابتدا اندازه اثر روی کاربران، سپس دستگاه و نسخه پلیر، منطقه و اپراتور، CDN و در نهایت Origin و ذخیرهسازی. در صورت کندی یک گروه، زمان دریافت Manifest، مجوز و نخستین Segment را مقایسه کنید. راهنمای کاهش Buffering و Latency و اجرای Load Test در VOD مکمل این عیبیابی است.
افزایش Cache Miss یا فشار Origin را با الگوی مصرف محتوا تفسیر کنید. یک محتوای تازه و پرطرفدار میتواند رفتار کش را تغییر دهد؛ برای بررسی این وابستگیها به معماری Storage، Cache و CDN در VOD مراجعه کنید.
سیاست بودجه خطا و مسئولیت محصول و SRE
ارزش مانیتورینگ و SLO در VOD زمانی مشخص میشود که روی اولویت کارها اثر بگذارد. پیش از حادثه توافق کنید در صورت مصرف سریع یا اتمام بودجه چه کسی میتواند انتشار پرریسک را متوقف کند و چه تغییرهایی برای رفع حادثه یا امنیت مجازند. توقف کورکورانه همه تغییرات ممکن است اصلاح همان خرابی را عقب بیندازد.
- مدیر محصول: تعیین تجربه حیاتی، گروههای کاربران و اولویت قابلیت در برابر پایداری.
- SRE و دواپس: صحت محاسبه، کیفیت هشدار، ظرفیت پاسخگویی و اجرای مانور.
- تیم پلیر و توسعه: ثبت درست رویدادها، اصلاح خطا و ارائه مسیر بازگشت نسخه.
- مالک خدمت: تصمیم درباره استثناها و ثبت دلیل پذیرش ریسک.
برای بازبینی مانیتورینگ و SLO در VOD پس از حادثه، مقدار بودجه مصرفشده، گروه آسیبدیده و علت فنی را ثبت کنید. بالا بردن استثناها یا پایین آوردن هدف صرفاً برای سبزشدن گزارش، بهبود کیفیت نیست. بازنگری هدف باید بر پایه تغییر نیاز محصول و شواهد انجام شود.
در مانور Failover هم تجربه پلیر و هم تازگی داده مقصد را بسنجید. SLO کیفیت دورهای خدمت را توصیف میکند؛ RPO و RTO هدف بازیابی یک حادثهاند و جای یکدیگر را نمیگیرند. مقاله پایداری و Disaster Recovery در VOD این بخش معماری را تکمیل میکند.
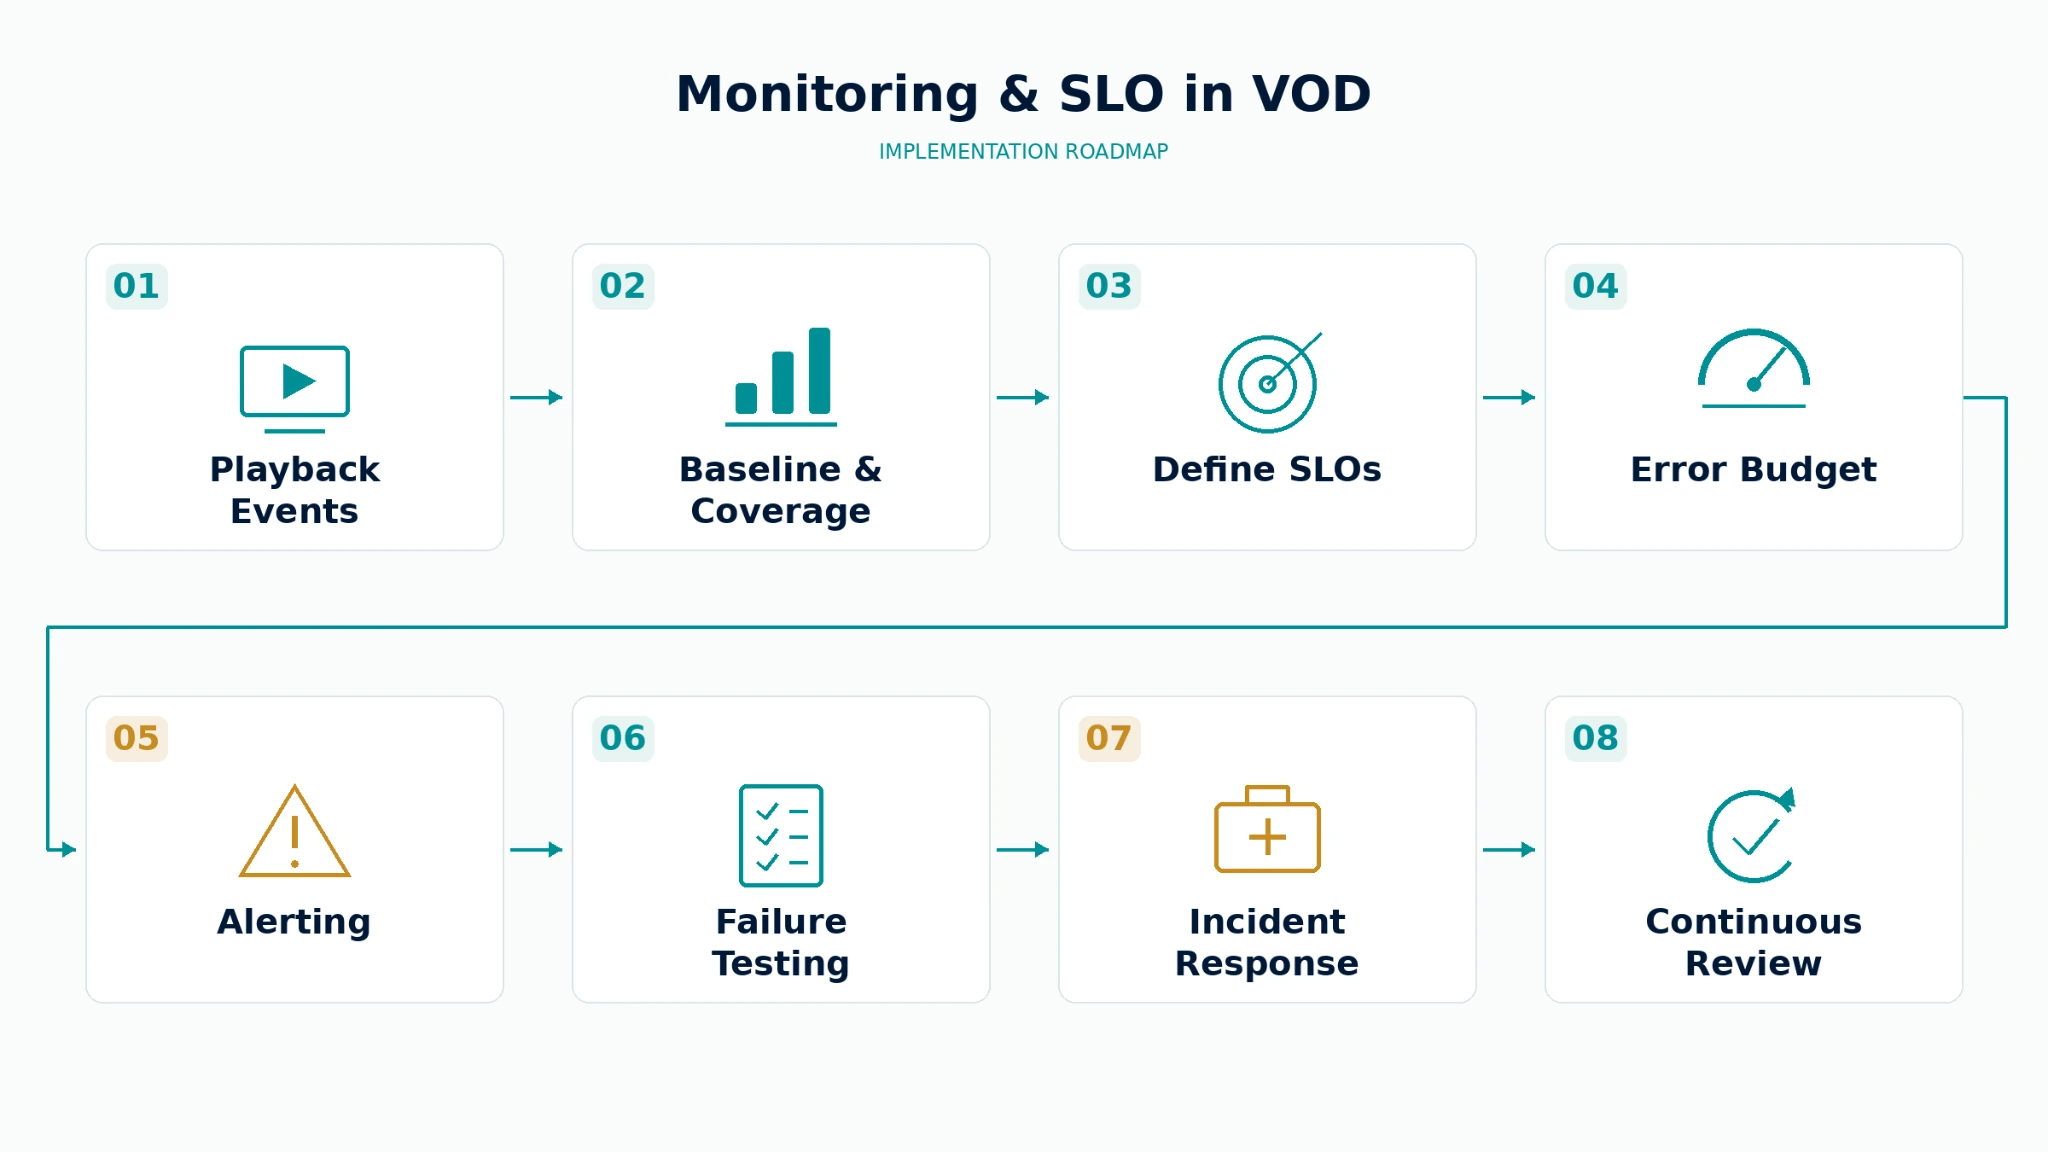
چکلیست اجرای مانیتورینگ و SLO در VOD
- مسیرهای مهم محصول و قرارداد رویدادهای پلیر را ثبت کنید.
- خط پایه و پوشش داده را در چند گروه واقعی بررسی کنید.
- برای شروع پخش و تداوم تماشا هدف مستقل تعریف کنید.
- بودجه و Burn Rate را با صورت و مخرج یکسان محاسبه کنید.
- هشدار چندپنجرهای، قطع تلهمتری و آزمون مصنوعی را کنار هم قرار دهید.
- شکست شروع، رویداد تکراری، تأخیر ارسال و نبود داده را آزمایش کنید.
- سیاست انتشار، مالک پاسخ و دستورالعمل بازیابی را مشخص کنید.
- پس از حادثه یا تغییر مهم، تعریف شاخص و کارایی هشدار را بازبینی کنید.
برای آزمون ظرفیت، از بار نماینده و خط پایه استفاده کنید؛ مقاله VOD Benchmark و سنجش ظرفیت زیرساخت به طراحی این مقایسه کمک میکند. موفقیت تست بار سرور را بهتنهایی اثبات کیفیت همه پلیرها در شبکه واقعی تلقی نکنید.
سؤالات متداول
آیا Uptime سرور برای سنجش کیفیت VOD کافی است؟
خیر؛ خرابی مجوز، Manifest یا مسیر CDN ممکن است با سرور سالم رخ دهد. تجربه شروع و ادامه پخش باید از سمت پلیر و آزمون مصنوعی سنجیده شود.
هدف مناسب SLO برای همه پلتفرمها یکسان است؟
خیر. آستانه و درصد هدف به خط پایه، دستگاهها، شبکه کاربران، اهمیت محصول و هزینه پایداری وابستهاند. اعداد این مقاله نمونه آموزشی هستند.
آیا خطای HTTP همان خطای پخش است؟
نه همیشه. Retry ممکن است خطای یک درخواست را بدون اثر محسوس جبران کند؛ در مقابل پاسخ HTTP موفق میتواند محتوای غیرقابلپخش داشته باشد. شاخص زیرساخت و تجربه کاربر را جدا نگه دارید.
با اتمام Error Budget چه کاری انجام دهیم؟
طبق سیاست از قبل توافقشده، تغییرهای پرریسک را محدود و اصلاح پایداری را اولویتبندی کنید. مالک تصمیم، استثناهای امنیتی و معیار بازگشت به انتشار عادی باید روشن باشد.
مهمترین خروجی مانیتورینگ و SLO در VOD چیست؟
یک توافق قابلاندازهگیری درباره تجربه قابل قبول کاربر، همراه با هشدار و اقدام مشخص. داشبورد زمانی مفید است که تیم بتواند از آن برای تشخیص اثر، اصلاح علت و مدیریت ریسک انتشار استفاده کند.