
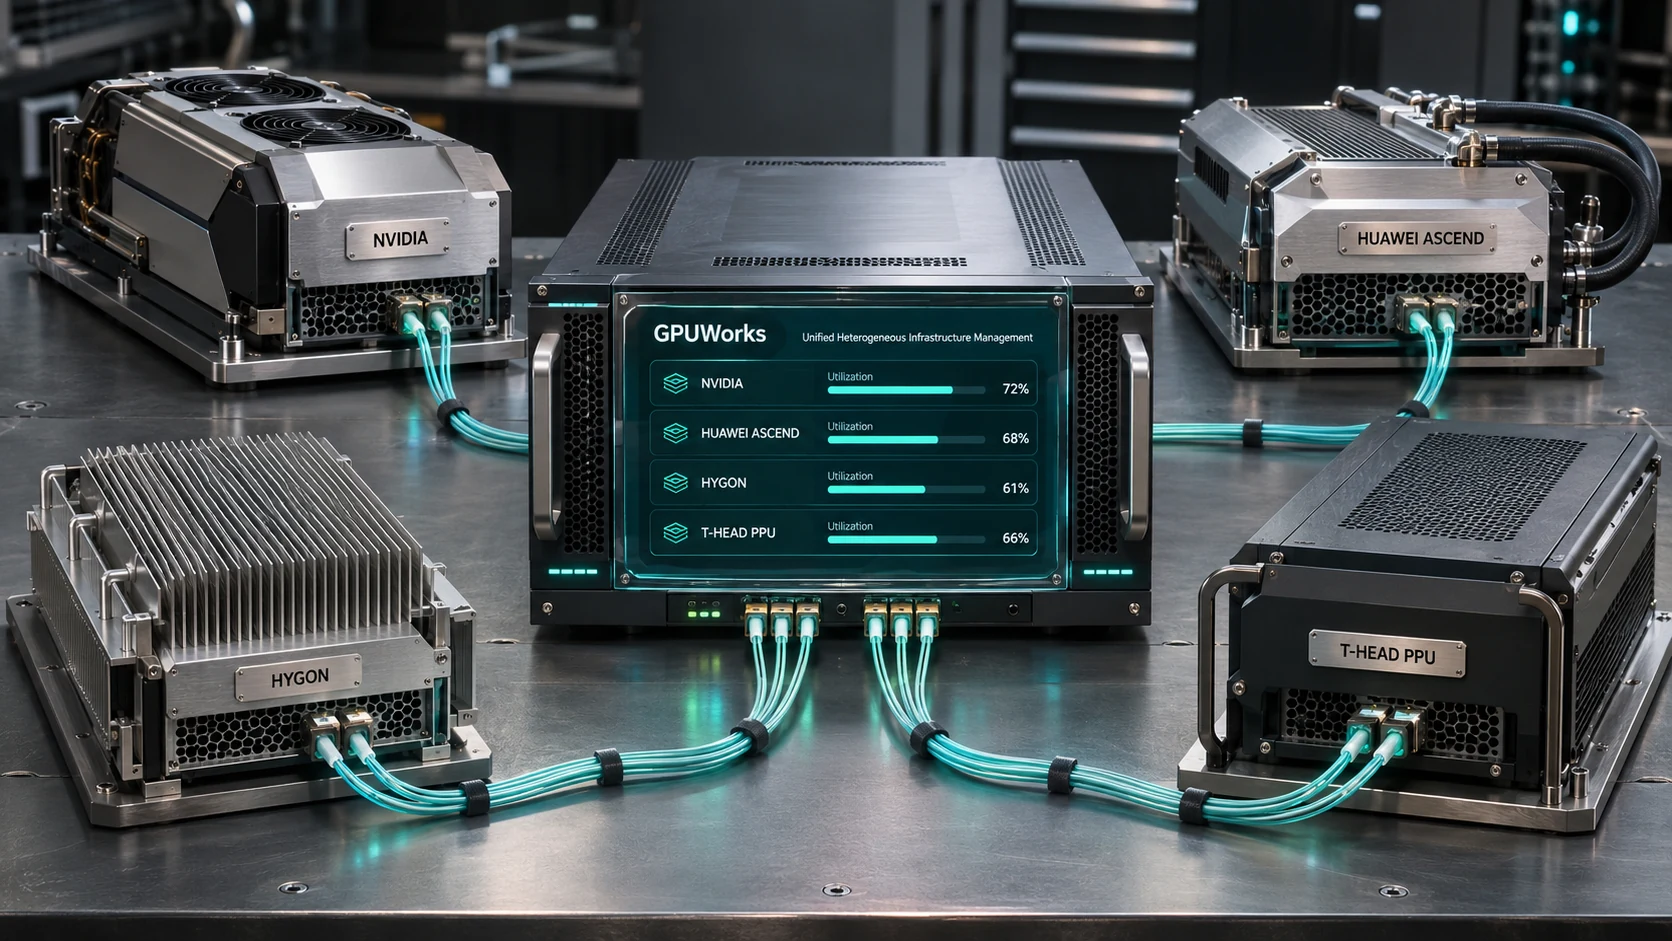
پلتفرم GPUWorks با هدف سادهتر کردن استفاده از سختافزارهای مختلف در زیرساخت هوش مصنوعی، بهصورت متنباز منتشر شده است. این پلتفرم با بسته نصب حدود ۴۰ مگابایتی، امکان استفاده از پردازندهها و شتابدهندههای هوش مصنوعی تولیدکنندگان مختلف را در یک کلاستر مشترک فراهم میکند.
بر اساس گزارش Pandaily، GPUWorks از سختافزارهای Huawei Ascend، T-Head PPU، Hygon و NVIDIA پشتیبانی میکند. این قابلیت به سازمانها اجازه میدهد بهجای محدود شدن به یک برند سختافزاری، از چند نوع پردازنده در یک زیرساخت پردازشی استفاده کنند.
اجرای سختافزارهای مختلف در یک کلاستر
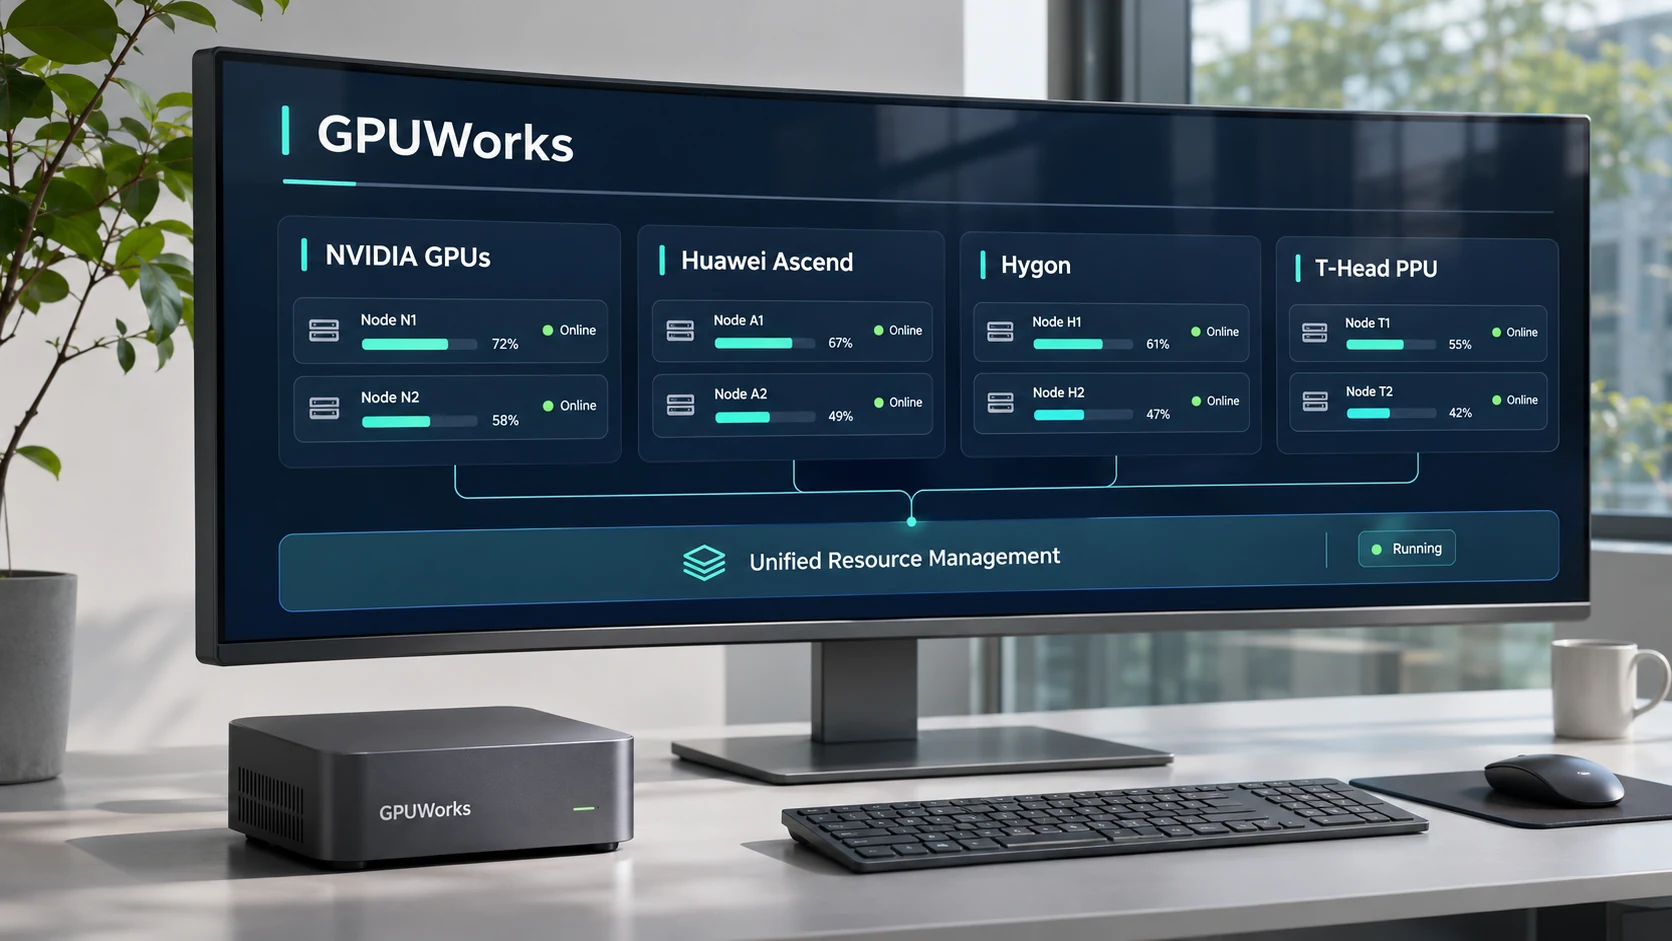
یکی از قابلیتهای اصلی GPUWorks، امکان تجمیع منابع پردازشی با معماریها و تولیدکنندگان متفاوت در یک کلاستر است. کلاستر به مجموعهای از منابع محاسباتی متصل گفته میشود که برای انجام وظایف پردازشی بهصورت هماهنگ فعالیت میکنند.
این قابلیت برای شرکتهایی که از چند نوع شتابدهنده هوش مصنوعی استفاده میکنند اهمیت دارد. چنین مجموعههایی معمولاً با چالش مدیریت سختافزارهای متنوع و استفاده هماهنگ از منابع پردازشی روبهرو هستند. GPUWorks تلاش میکند این منابع را در یک محیط مشترک در دسترس قرار دهد.
ادعای مدیریت ۱۰۰۳ سرور GPU
طبق اعلام رسمی سازنده، یک نمونه GPUWorks Server در آزمایش داخلی مدیریت ۱۰۰۳ سرور GPU را بر عهده داشته است. منظور، مدیریت سرورهای مستقل از یک نقطه کنترلی است، نه اجرای ۱۰۰۳ ماشین درون یک سرور.
این اعداد ادعای سازندهاند و معادل ارزیابی مستقل نیستند. برای تصمیمگیری عملیاتی، باید مشخصات سختافزار، مدلهای اجراشده، الگوی بار و معیارهای اندازهگیری با نیاز سازمان مقایسه شوند. تعداد سرورهای تحت مدیریت بهتنهایی توان پاسخگویی مدلها را مشخص نمیکند.
انتشار GPUWorks با مجوز Apache-2.0
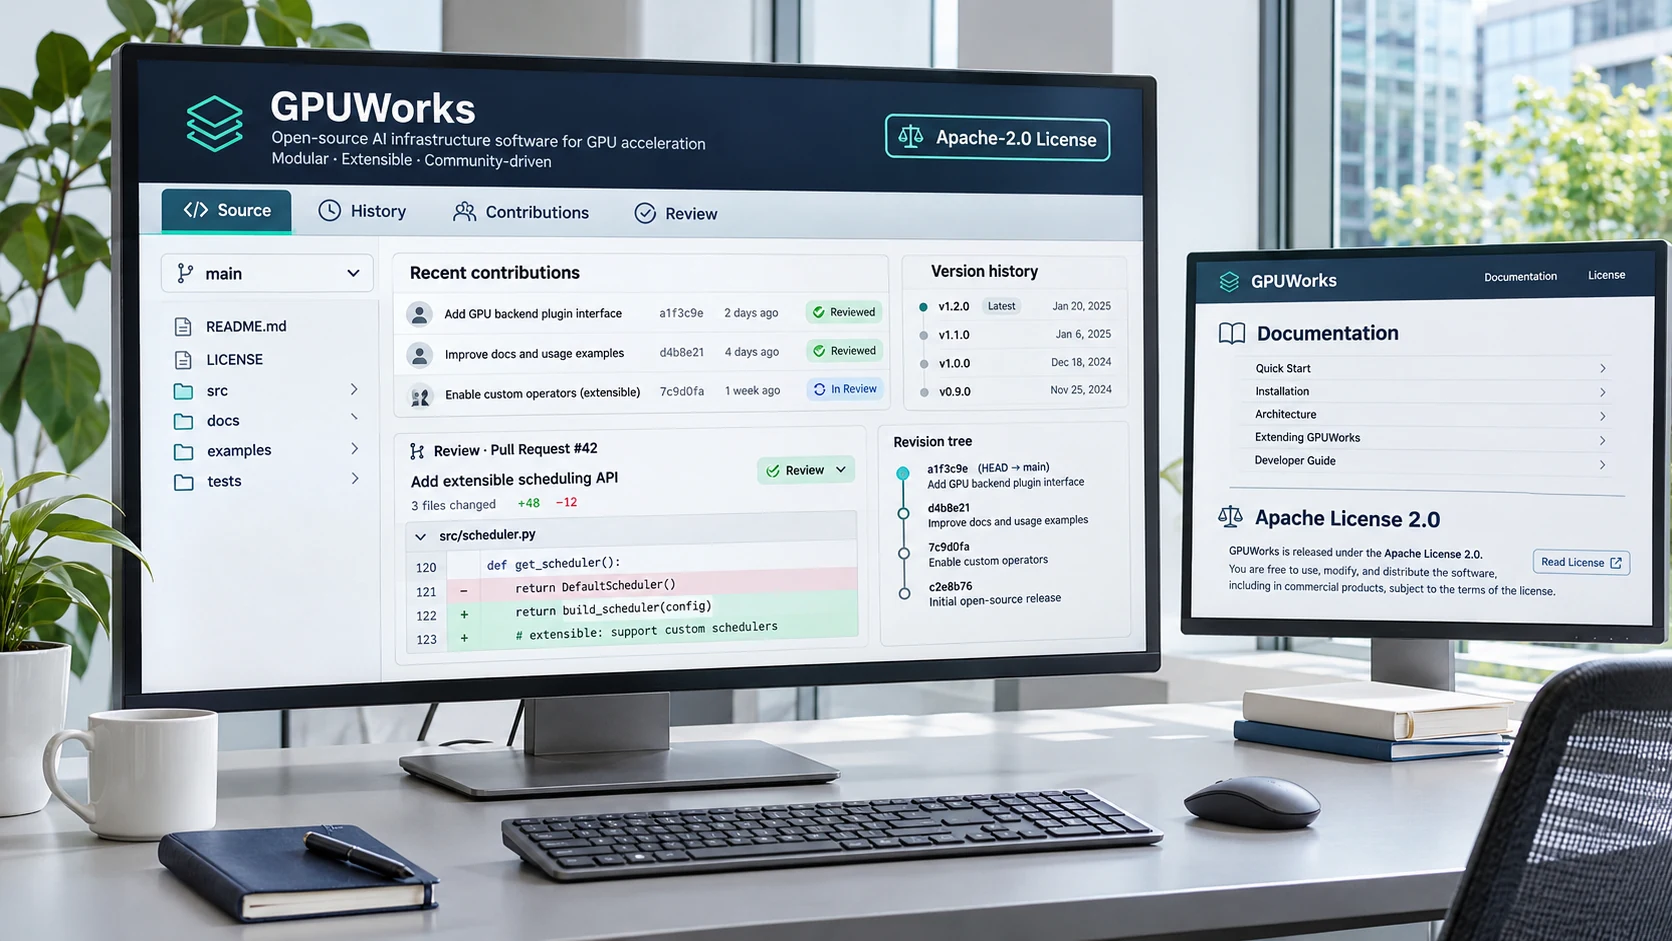
این پلتفرم تحت مجوز Apache-2.0 منتشر شده است؛ مجوزی متنباز که به توسعهدهندگان اجازه میدهد مطابق شرایط آن از کد نرمافزار استفاده کنند، آن را بررسی کنند و در توسعهاش مشارکت داشته باشند.
انتشار GPUWorks بهصورت متنباز میتواند فرصت مناسبی برای بررسی قابلیتهای آن توسط توسعهدهندگان، شرکتهای فعال در حوزه زیرساخت هوش مصنوعی و تیمهایی باشد که از سختافزارهای پردازشی متنوع استفاده میکنند.
پیش از استفاده چه مواردی را بررسی کنیم؟
مدیریت چند برند در یک کلاستر به معنای سازگاری همه مدلها با همه شتابدهندهها نیست. تیم فنی باید سازگاری مدل، درایور و موتور استنتاج را جداگانه بررسی کند و پیش از مهاجرت، یک بار کاری نماینده را روی سختافزار مقصد بیازماید.
برای آشنایی با کاربرد دیگری از هوش مصنوعی در مدیریت زیرساخت، خبر معرفی Console AI اوراکل برای مدیریت منابع ابری را بخوانید. این دو ابزار کاربرد یکسانی ندارند؛ یکی بر زیرساخت استنتاج تمرکز دارد و دیگری تعامل با سرویسهای ابری را ساده میکند.
جمعبندی
GPUWorks با پشتیبانی از سختافزارهای NVIDIA، Huawei Ascend، Hygon و T-Head، رویکردی برای استفاده مشترک از پردازندههای مختلف در زیرساخت هوش مصنوعی ارائه میدهد. انتشار این پلتفرم با مجوز Apache-2.0 نیز امکان بررسی و توسعه آن را برای جامعه متنباز فراهم میکند.
اگرچه مدیریت ۱۰۰۳ سرور GPU از سوی توسعهدهندگان مطرح شده، اطلاعات فنی منتشرشده هنوز برای ارزیابی مستقل عملکرد و مقیاسپذیری این پلتفرم کافی نیست.
منبع: Pandaily