
پایداری و Disaster Recovery در VOD فقط با داشتن دو سرور یا یک نسخه پشتیبان به دست نمیآید. سرویس ویدئوی درخواستی زمانی تابآور است که هنگام خرابی، کاربر بتواند وارد شود، مجوز پخش بگیرد و قطعات سالم ویدئو را دریافت کند. ممکن است فایلها در سایت دوم موجود باشند، اما خرابی پایگاه داده یا سرویس صدور مجوز، شروع همه پخشهای جدید را متوقف کند.
این راهنمای پایداری و Disaster Recovery در VOD برای تیمهای دواپس و مدیران زیرساخت، مسیر طراحی دسترسپذیری بالا، انتخاب راهبرد بازیابی و آزمون واقعی آن را توضیح میدهد. محور بحث، معماری مستقل از فروشنده است؛ نمونههای مستند سرویسها صرفاً برای روشنکردن محدودیتهای اجرایی آورده شدهاند. برای شناخت اجزای پایه، ابتدا راهنمای معماری زیرساخت VOD را ببینید.
تفاوت High Availability و Disaster Recovery در VOD
High Availability یا HA برای ادامه خدمت در خرابیهای تعریفشده، مانند ازکارافتادن یک پردازش، نود یا دامنه خرابی طراحی میشود. Disaster Recovery یا DR برنامه بازگرداندن خدمت و داده پس از رویدادی است که ظرفیت معماری عادی را پشت سر میگذارد؛ برای مثال ازدسترفتن یک سایت، حذف گسترده محتوا یا فساد داده.
مرز این دو به مدل تهدید شما بستگی دارد. دو ماشین مجازی روی یک میزبان، دو رک با برق مشترک یا دو سایت وابسته به یک سامانه هویت، لزوماً استقلال خرابی ایجاد نمیکنند. برای پایداری و Disaster Recovery در VOD باید دامنه خرابی را از برق و شبکه تا ذخیرهسازی، حساب مدیریتی و تغییرات نرمافزاری مشخص کنید.
| مفهوم | مسئله اصلی | نمونه در VOD |
|---|---|---|
| HA | ادامه خدمت با وجود خرابی محدود | خروج یک Origin از مدار و ادامه تحویل از Origin سالم |
| Replication | ایجاد کپی بهروز از داده | انتقال فایلهای ویدئو و تغییرات پایگاه داده به سایت دوم |
| Backup | حفظ نسخه قابل بازیابی از گذشته | بازگرداندن محتوای حذفشده یا پایگاه داده قبل از خطای انسانی |
| DR | بازیابی هماهنگ کل خدمت | فعالکردن سایت جایگزین همراه با داده، مجوز پخش و مسیر ترافیک |
Replication جای Backup را نمیگیرد؛ تغییر نادرست میتواند به نسخههای دیگر هم منتقل شود. همچنین CDN یک سامانه پشتیبانگیری کامل نیست: محتوا ممکن است از کش خارج شود و درخواست مجوز یا فایل کمطرفدار همچنان به مبدأ نیاز داشته باشد.
تعیین RPO، RTO و سطح خدمت
RPO هدف مربوط به میزان قابلقبول ازدسترفتن داده بر حسب زمان است. RTO هدف زمان بازگرداندن خدمت پس از اختلال است. مثلاً RPO پنجدقیقهای به معنی پذیرش بالقوه ازدسترفتن حداکثر پنج دقیقه تغییرات در سناریوی تعریفشده است؛ این مقدار با برنامه بکاپ یا فعالبودن Replication خودبهخود تضمین نمیشود.
در برنامه پایداری و Disaster Recovery در VOD، برای همه دادهها یک عدد تعیین نکنید. پرداخت و حق دسترسی، فایل منبع، وضعیت انتشار، سابقه تماشا و آمار تحلیلی ارزش و حساسیت متفاوت دارند. RTO را نیز برای «پخش محتوای موجود» و «انتشار محتوای جدید» جدا تعریف کنید.
| جزء خدمت | اولویت نمونه | پرسش تعیینکننده |
|---|---|---|
| مجوز پخش و حق دسترسی | بسیار بالا | آیا کاربر مجاز پس از انتقال میتواند پخش جدید شروع کند؟ |
| کتابخانه ویدئوی منتشرشده | بالا | چه سهمی از آرشیو باید بلافاصله قابل پخش باشد؟ |
| فایل منبع و خروجیهای تبدیلشده | وابسته به ارزش محتوا | بازسازی خروجیها چقدر زمان و ظرفیت نیاز دارد؟ |
| بارگذاری و Transcoding | قابل تفکیک از پخش | چه مدت توقف انتشار جدید قابل قبول است؟ |
| تاریخچه تماشا و تحلیل رفتار | وابسته به محصول | چه مقدار تأخیر یا ازدسترفتن داده پذیرفتنی است؟ |
نمونه آموزشی: یک سرویس میتواند بازگشت پخش کتابخانه موجود در ۳۰ دقیقه و بازگشت انتشار جدید در ۴ ساعت را هدف بگیرد. این اعداد پیشنهاد عمومی یا SLA نیستند؛ باید با اثر کسبوکاری، هزینه و نتیجه مانور تأیید شوند. SLO دسترسپذیری نیز جای RPO و RTO را نمیگیرد؛ اولی سطح خدمت در یک بازه را میسنجد و دو مورد دیگر هدف بازیابی یک حادثهاند.
معماری مرجع پایداری و Disaster Recovery در VOD
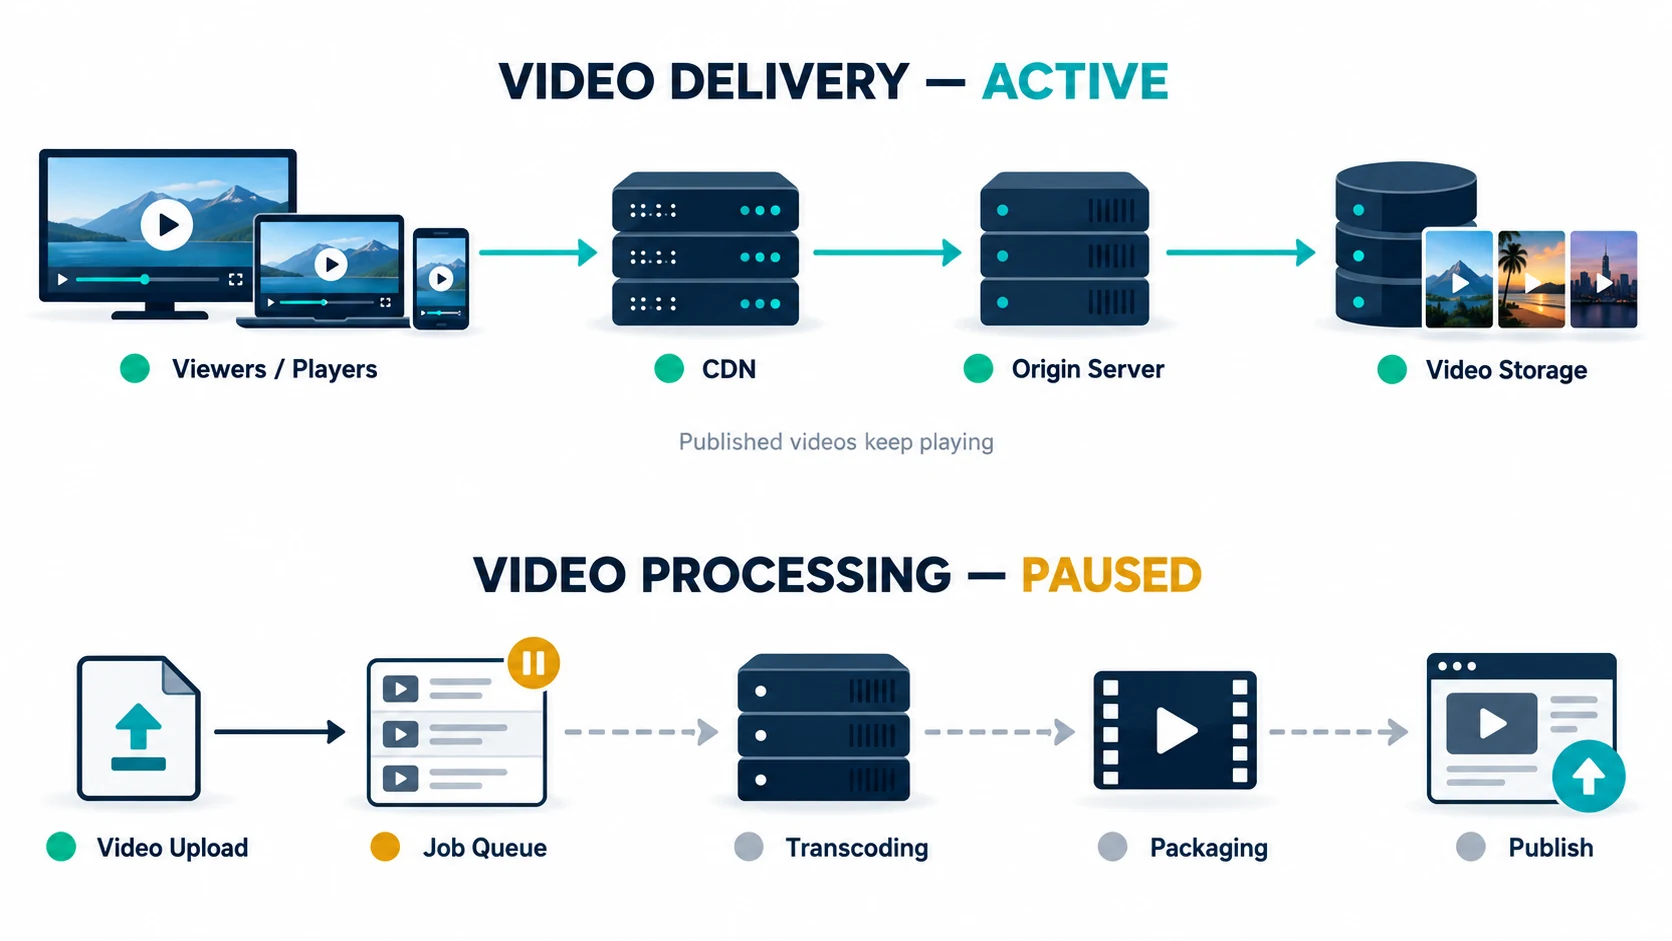
مسیر تحویل ویدئو را از مسیر پردازش جدا کنید
مسیر پخش معمولاً از پلیر به CDN، سپس Origin و ذخیرهساز میرسد؛ در کنار آن، API، احراز هویت و مجوز پخش قرار دارند. مسیر آمادهسازی شامل بارگذاری، صف کار، Transcoding، بستهبندی و انتشار است. خرابی صف تبدیل نباید بیدلیل پخش ویدئوهای آماده را متوقف کند.
در هر سایت، سرویسهای بدون وضعیت را در چند نود و دامنه خرابی توزیع کنید. وضعیت نشست، داده پایدار و صف کار را از دیسک محلی آنها جدا نگه دارید. Load Balancer، DNS، مدیریت اسرار و رجیستری بستهها نیز باید در فهرست وابستگیها باشند؛ افزونگی فقط در لایه برنامه کافی نیست.
یک معماری دوسایتی با مرز مسئولیت روشن بسازید
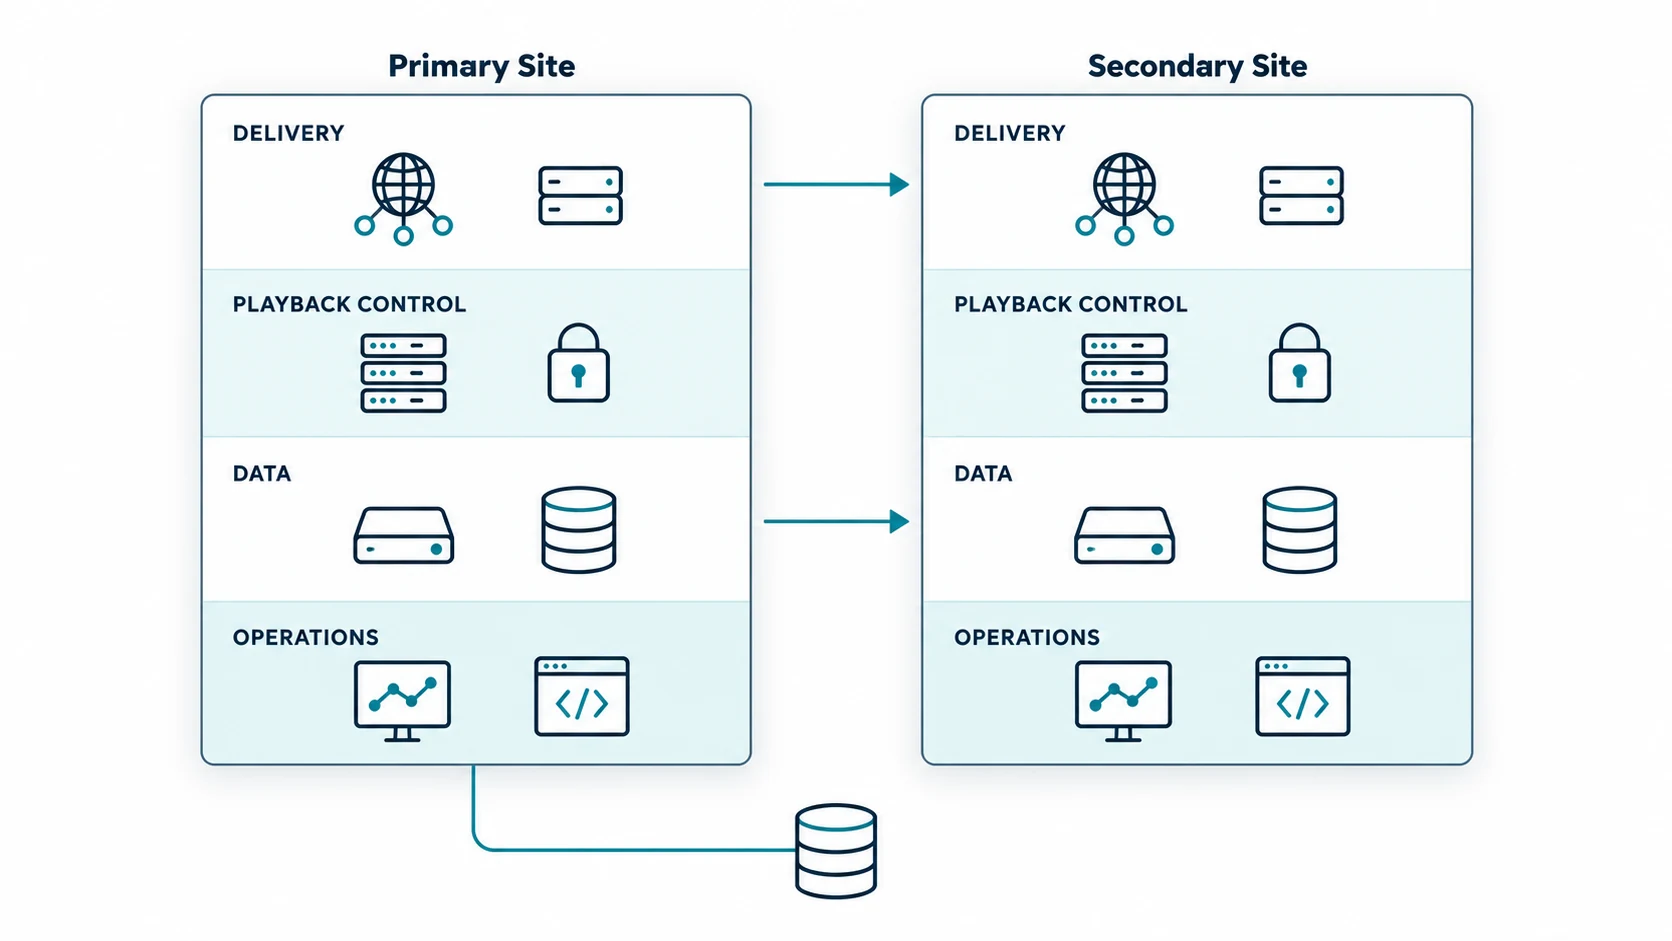
یک الگوی قابل بررسی، سایت اصلی با HA داخلی و سایت دوم با سرویس پخش آماده یا نیمهآماده است. کپی مستقل محتوا و داده در سایت دوم نگهداری میشود و پشتیبانهای نسخهدار در محدوده دسترسی جدا قرار میگیرند. وضعیت آمادهبودن سایت دوم باید از بیرون سایت اول قابل مشاهده باشد.
- لایه تحویل: CDN با Origin جایگزین و سیاست مشخص انتقال ترافیک.
- لایه کنترل پخش: API کاتالوگ، احراز مجوز و در صورت استفاده، سرویس DRM قابل بازیابی.
- لایه داده: ذخیرهساز محتوا، پایگاه داده و صفها با سیاست سازگاری و بازیابی مشخص.
- لایه عملیات: زیرساخت بهصورت کد، نسخه تنظیمات، پایش مستقل و دستورالعمل اجرایی بحران.
برای پایداری و Disaster Recovery در VOD، وابستگی پنهان را حذف کنید: اگر راهاندازی سایت دوم به فایل استقرار، کلید یا سامانه مدیریتی در سایت ازدسترفته نیاز داشته باشد، بازیابی در عمل متوقف میشود.
همگامسازی محتوا و حفاظت از داده
یکپارچگی Asset را پیش از انتشار تأیید کنید
هر ویدئو مجموعهای از Manifest، قطعات تصویر و صوت، زیرنویس، تصویر پوستر و گاهی فایل آغازین است. وجود Manifest در مقصد اثبات نمیکند همه قطعات آن رسیدهاند. برای هر نسخه Asset، فهرست فایلها، اندازه و Checksum ثبت کنید و پس از تأیید کاملبودن مقصد، آن نسخه را برای پخش از سایت دوم آماده اعلام کنید.
آدرسهای نسخهدار و خروجیهای تغییرناپذیر، مدیریت کش و تطبیق محتوا را سادهتر میکنند. انتشار تدریجی فایلها نباید باعث شود پلیر به نسخه ناقص هدایت شود. نگهداری فقط فایل منبع ممکن است هزینه ذخیرهسازی را کم کند، اما زمان بازتبدیل کل کتابخانه میتواند RTO را ناممکن کند.
رفتار Replication و حذف را واقعاً آزمایش کنید
برای پایداری و Disaster Recovery در VOD، تأخیر انتقال، صف اشیای معوق و خطاهای مجوز را پایش کنید. رفتار حذف و نسخهبندی به محصول و تنظیمات وابسته است. برای نمونه، در S3 انتقال Delete Marker تنظیم جداگانه دارد و همه تنظیمات Bucket یا اشیای قدیمی الزاماً با فعالکردن یک قانون Replication منتقل نمیشوند؛ مستندات همان نسخه و پیکربندی باید مبنا باشد.
کپی مقصد را با نمونهبرداری از ویدئوهای قدیمی، جدید، پرطرفدار و کمطرفدار بررسی کنید. نسخه پشتیبان باید در برابر حذف با همان حساب عملیاتی محافظت شود. نگهداری نسخهها، جداسازی دسترسی و در صورت نیاز قابلیت تغییرناپذیری را همراه با آزمون Restore در نظر بگیرید.
پایگاه داده، کلیدها و وضعیت کارها را فراموش نکنید
در طراحی پایداری و Disaster Recovery در VOD، بازیابی فایل بدون اطلاعات مالکیت، حق دسترسی و وضعیت انتشار کافی نیست. برای پایگاه داده از روش بازیابی متناسب با محصول استفاده کنید. مثلاً در PostgreSQL، بازیابی نقطهای با یک Base Backup و زنجیره پیوسته WAL انجام میشود؛ یک خروجی منطقی معمولی بهتنهایی جای این زنجیره را نمیگیرد.
نسخه طرح پایگاه داده باید با نسخه برنامه مقصد سازگار باشد. اسرار و کلیدهای رمزنگاری را با سازوکار امنِ خود سامانه مدیریت کلید بازیابی کنید؛ کپیکردن ساده فایل تنظیمات جای این طراحی را نمیگیرد. کارهای صف باید شناسه ثابت و پردازش تکرارپذیر امن داشته باشند تا اجرای دوباره یک کار باعث انتشار مضاعف یا تخریب خروجی نشود.
انتخاب راهبرد بازیابی بحران
انتخاب راهبرد پایداری و Disaster Recovery در VOD به سرعت بازیابی موردنیاز، حجم آرشیو، نرخ تغییر داده و توان تیم عملیات وابسته است. الگوهای زیر جهت مقایسهاند؛ زمان واقعی هر کدام فقط با تست محیط شما مشخص میشود.
| راهبرد | وضعیت سایت دوم | مزیت | محدودیت |
|---|---|---|---|
| Backup & Restore | بازیابی از پشتیبان پس از حادثه | هزینه آمادهبهکاری کمتر | انتقال داده و راهاندازی ممکن است طولانی شود |
| Pilot Light | داده و اجزای پایه حفظ میشوند؛ ظرفیت پردازش محدود یا خاموش است | کاهش هزینه نسبت به آمادهبهکاری کامل | به تأمین ظرفیت و تکمیل استقرار وابسته است |
| Warm Standby | نسخه کوچکتر اما عملیاتی خدمت فعال است | مسیر بازیابی قابل آزمون و معمولاً سریعتر | باید افزایش ظرفیت و کش سرد آزمایش شود |
| Active-Active | چند سایت همزمان خدمت میدهند | توزیع بار و استفاده مستمر از سایتها | سازگاری داده، تعارض نوشتن و عملیات پیچیدهتر |
برای بسیاری از سامانهها، راهبرد ترکیبی منطقی است: تحویل ویدئوی آماده در سایت دوم سریع بازیابی شود، اما پردازش دستهای و گزارشگیری با تأخیر بازگردند. Active-Active الزاماً RPO صفر ایجاد نمیکند؛ اگر داده بهصورت ناهمگام تکثیر شود، آخرین تغییرات ممکن است هنوز به سایت دیگر نرسیده باشند.
Replication همگام میتواند در محدوده تضمینهای مشخص خود ریسک ازدسترفتن تغییرات تأییدشده را کاهش دهد، اما روی تأخیر نوشتن و رفتار زمان قطع ارتباط اثر دارد. انتخاب آن باید با مدل سازگاری، فاصله سایتها و نیاز واقعی محصول انجام شود.
طراحی Failover و بازگشت به سایت اصلی
سلامت را در سطح یک پخش واقعی بسنجید
پاسخ ۲۰۰ یک صفحه سلامت کافی نیست. بررسی مصنوعی باید دریافت Manifest، قطعه ویدئو و در محتوای حفاظتشده دریافت مجوز را پوشش دهد. برای جلوگیری از رفتوبرگشت مکرر ترافیک، چند مشاهده متوالی، حداقل زمان تثبیت و شرط روشن بازگشت تعریف کنید.
در پایداری و Disaster Recovery در VOD، انتخاب خودکار یا دستی Failover تصمیمی عملیاتی است. خرابی ساده یک Origin بدون وضعیت میتواند خودکار مدیریت شود؛ اما انتقال نویسنده پایگاه داده، وقتی وضعیت سایت قبلی نامشخص است، به کنترل دقیقتری نیاز دارد.
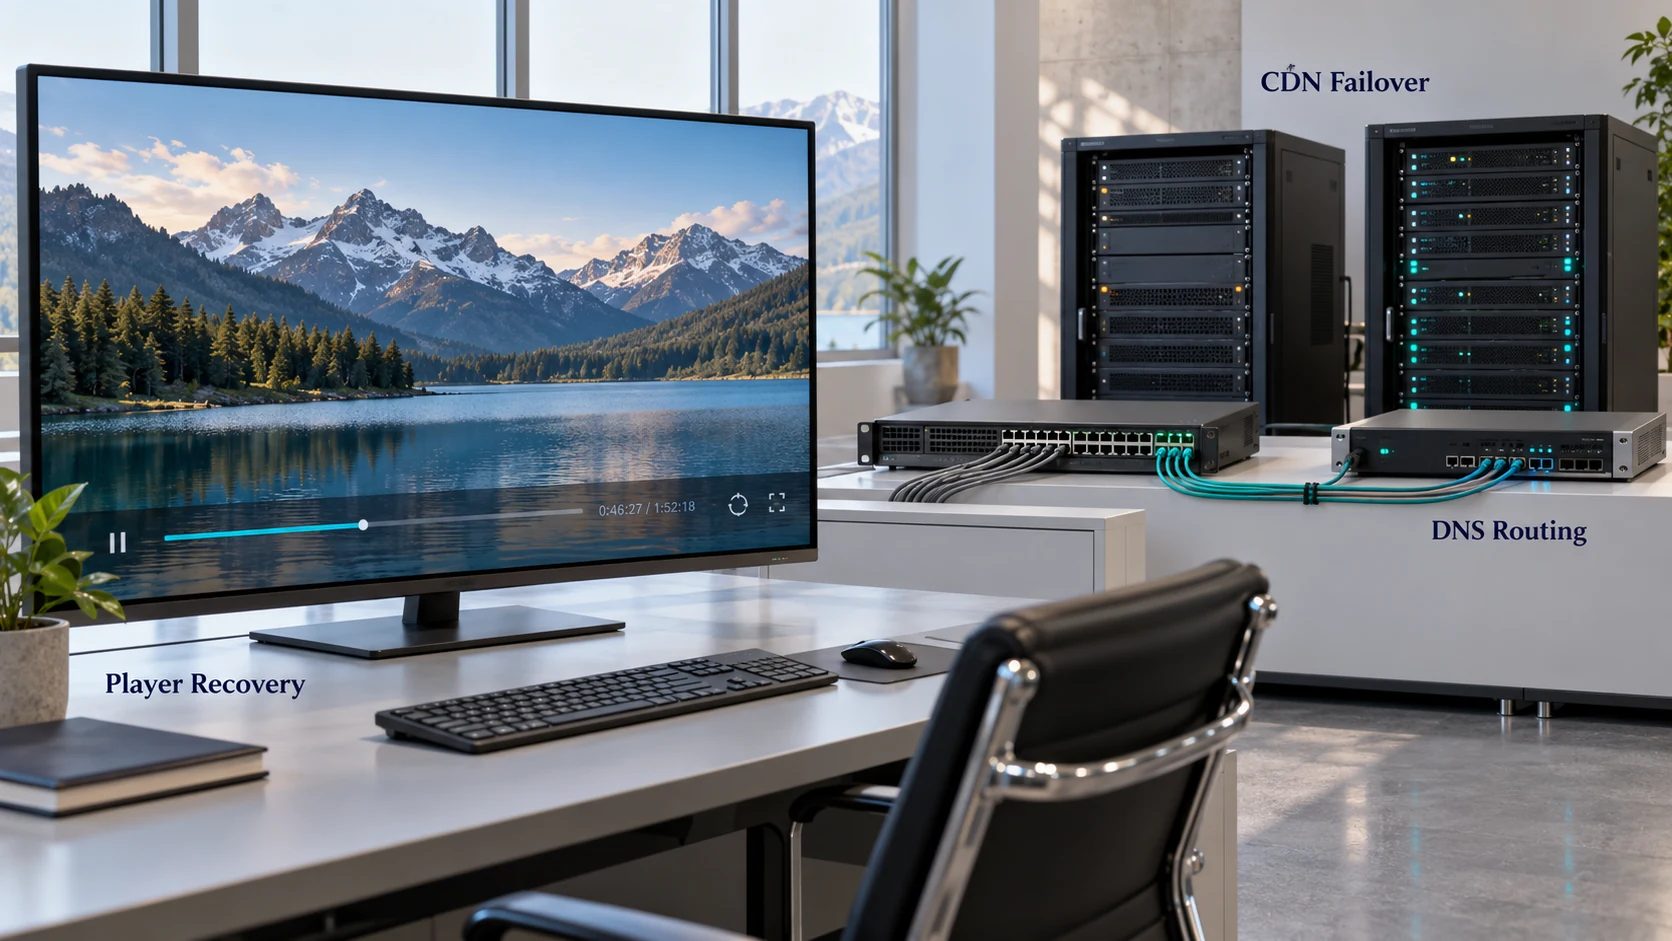
محدودیت CDN، DNS و پلیر را در نظر بگیرید
قابلیت Origin Failover در همه CDNها یکسان نیست. برای نمونه، CloudFront انتقال به مبدأ دوم را برای درخواستهای GET، HEAD و OPTIONS و بر اساس شرایط خطای پیکربندیشده انجام میدهد. این قابلیت بهتنهایی بازیابی همه APIهای نوشتنی یا تراکنشهای برنامه را پوشش نمیدهد.
تغییر DNS نیز آنی نیست؛ کش Resolver، TTL و اتصالهای موجود روی زمان انتقال اثر دارند. هر دو مسیر باید گواهی معتبر، CORS مناسب، توکن قابل اعتبارسنجی و نامگذاری سازگار محتوا داشته باشند. تغییر مقصد نباید با حذف احراز مجوز یا بازکردن عمومی محتوا همراه شود.
در Multi-CDN، تشخیص اختلال باید از چند شبکه و منطقه انجام شود. خرابی یک مسیر یا اپراتور لزوماً خرابی کل CDN نیست. پلیر نیز باید Retry محدود و رفتار بازیابی معقول داشته باشد تا تلاشهای همزمان، مبدأ جایگزین را زیر فشار نبرند.
از Split-Brain و بازگشت شتابزده جلوگیری کنید
پیش از ارتقای پایگاه داده مقصد، باید از ادامه نوشتن مستقل در سایت قبلی جلوگیری شود؛ این کنترل معمولاً با سازوکار انتخاب رهبر، Quorum و Fencing متناسب با سامانه انجام میشود. قطع ارتباط شبکه بهتنهایی ثابت نمیکند سایت اصلی خاموش است.
در چرخه پایداری و Disaster Recovery در VOD، بازگشت به سایت اصلی یا Failback یک تغییر مستقل است. ابتدا سایت اولیه را بازسازی، دادهها را از منبع حقیقت فعلی همگام و صحت آنها را کنترل کنید؛ سپس ترافیک را مرحلهای برگردانید. روشنشدن دوباره سرور قبلی مجوز بازگرداندن فوری ترافیک نیست.
ظرفیت سایت جایگزین و عملکرد در بحران
یکی از خطاهای رایج در پایداری و Disaster Recovery در VOD، سنجش سایت دوم فقط با بار عادی خودش است. ظرفیت باقیمانده باید بار پذیرفتهشده پس از خرابی، درخواستهای تکراری و افزایش Cache Miss را تحمل کند. در دو سایت Active-Active که هر کدام نصف ترافیک را میگیرند، ازدسترفتن یک سایت میتواند سهم بار سایت سالم را تقریباً دو برابر کند.
برآورد اولیه خروجی سمت کاربران:
پخش همزمان × متوسط نرخ بیت تحویلشده × ضریب سربار
نمونه فرضی: ۵۰۰۰ پخش × ۳ مگابیتبرثانیه × ۱٫۲ = ۱۸ گیگابیتبرثانیه
این عدد، خروجی کل تحویل به کاربران است و نباید مستقیماً ظرفیت Origin فرض شود. بار مبدأ به اصابت کش بایتی، توزیع محتوا، کش سرد و مسیر CDN وابسته است. برای جزئیات این تفکیک، راهنمای ذخیرهسازی، Cache و CDN در VOD را بخوانید.
در طرح کاهش سطح خدمت، میتوان انتشار جدید یا پردازش غیرضروری را موقتاً متوقف کرد و، در صورت وجود نسخههای مناسب و پذیرش محصول، سقف کیفیت را کاهش داد. این رفتار باید از قبل تعریف و آزمایش شود؛ تصمیم بداهه در بحران ممکن است تجربه کاربر یا یکپارچگی محتوا را بدتر کند.
مانیتورینگ و مانور بازیابی
داشبورد پایداری و Disaster Recovery در VOD باید سلامت سرویس، آمادگی بازیابی و تجربه کاربر را کنار هم نشان دهد. سبزبودن CPU و شبکه، بدون دانستن تازگی داده مقصد و قابلیت پخش، تصویر ناقصی از آمادگی میدهد.
- آمادگی داده: تأخیر Replication، تعداد Asset ناقص، سن آخرین بکاپ سالم و آخرین Restore موفق.
- سلامت خدمت: خطای Manifest و Segment، دسترسپذیری مجوز، تأخیر API و اشباع Origin.
- کیفیت پخش: موفقیت شروع پخش، زمان اولین فریم، نسبت توقف و Seek در شبکهها و دستگاههای مختلف.
- آمادگی عملیات: اعتبار گواهی، دسترسی کلید، ظرفیت رزروشده و امکان اجرای دستورالعمل از سایت سالم.
برای طراحی شاخصها و سناریوهای فشار، مقاله کاهش Latency و Buffering و اجرای Load Test در VOD مکمل این بحث است. همچنین راهنمای VOD Benchmark به ثبت خط پایه و مقایسه ظرفیت پیش و پس از تغییر کمک میکند.
| سناریوی مانور | آنچه باید اندازهگیری شود | شرط پایان |
|---|---|---|
| قطع یک Origin | زمان تشخیص و اثر روی شروع و ادامه پخش | تحویل از مسیر سالم با خطای قابل قبول |
| خروج کامل سایت اصلی | زمان فعالسازی، تازگی داده و ظرفیت مقصد | پخش جدید و محتوای منتخب در بار توافقشده |
| حذف یا خرابی یک Asset | امکان بازیابی نسخه سالم و سازگاری Manifest | پخش کامل نسخه بازیابیشده |
| فساد منطقی پایگاه داده | بازیابی تا نقطه سالم و تطبیق حق دسترسی | صحت داده و مجوز در محیط ایزوله |
| بازگشت سایت اولیه | همگامسازی معکوس و انتقال تدریجی بار | پایداری بدون تعارض نوشتن |
مانور را از محیط ایزوله و بار محدود شروع کنید و قبل از آزمون روی سرویس زنده، سقف اثر، مسئول تصمیم و شرط توقف مشخص باشد. زمان حادثه فرضی، تشخیص، تصمیم، انتقال و بازگشت پخش را ثبت کنید. RTO مشاهدهشده باید از مبدأ زمانی توافقشده تا تحقق معیار خدمت محاسبه شود، نه صرفاً زمان روشنشدن ماشین جایگزین.
RPO مشاهدهشده نیز باید با آخرین داده قابل استفاده مقصد سنجیده شود. تست Restore موفق روی یک جدول، بازیابی هماهنگ کل VOD را اثبات نمیکند. نتیجه هر مانور باید به اصلاح معماری، ظرفیت یا دستورالعمل و سپس آزمون مجدد منجر شود.
نقشه راه و چکلیست اجرایی
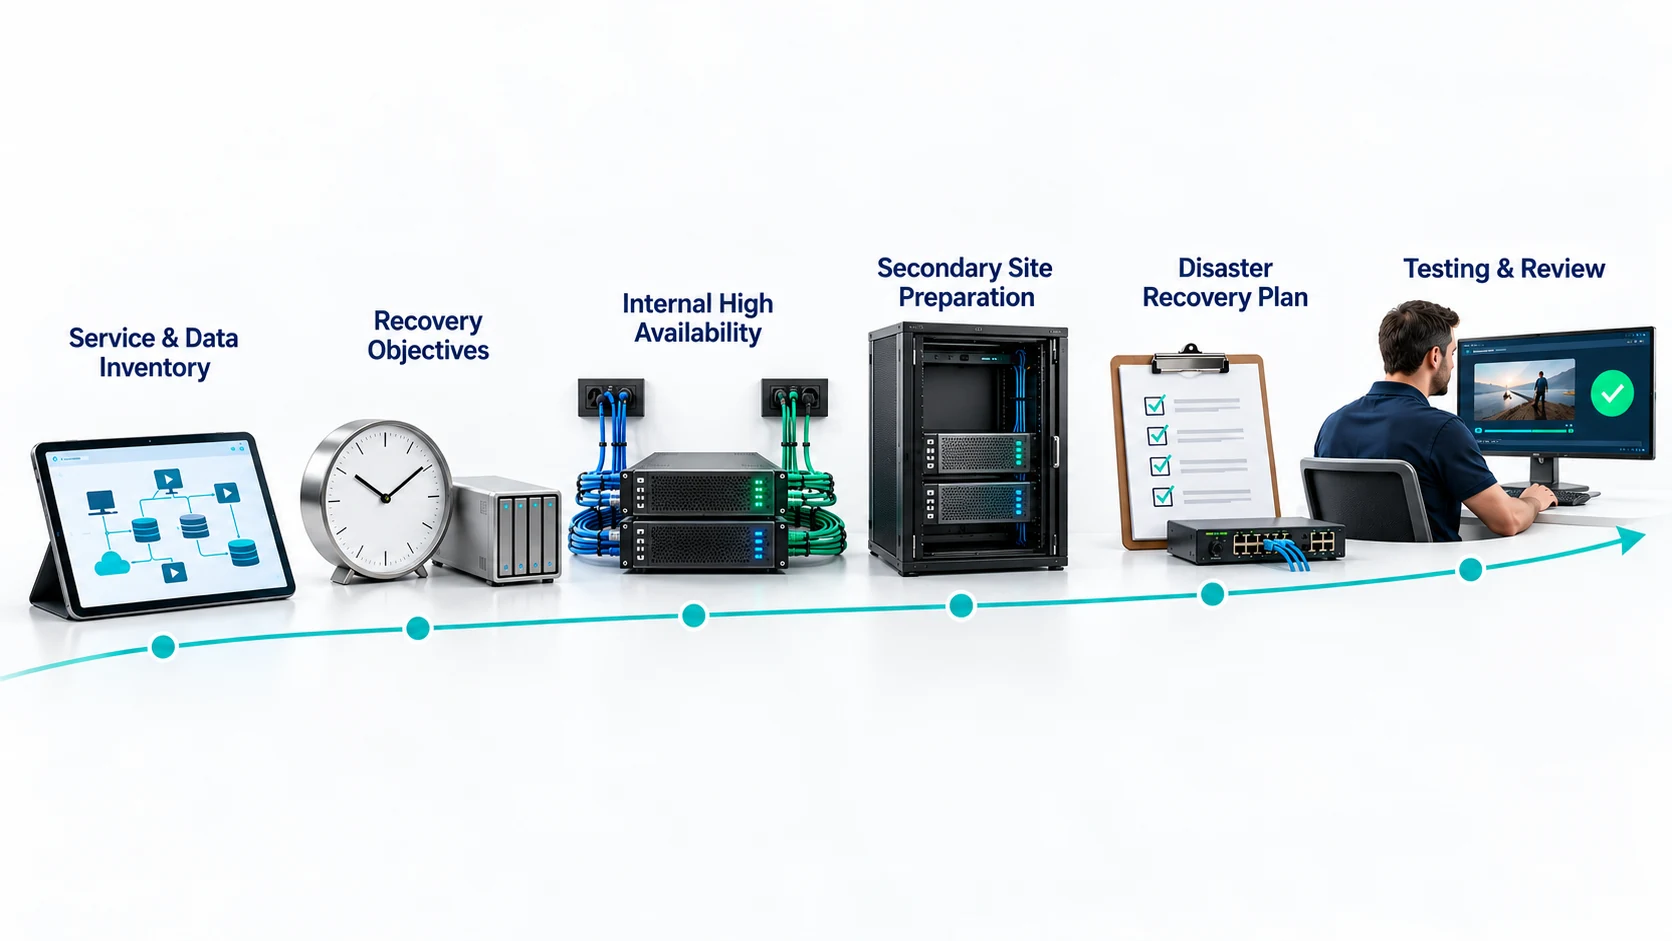
اجرای پایداری و Disaster Recovery در VOD را با گامهای کوچک و قابل ارزیابی پیش ببرید. هدف نخست، شناخت وابستگی و بازیابی قابل اثبات است؛ پیچیدهترین معماری لزوماً مناسبترین انتخاب نیست.
- فهرست خدمت و داده: مسیر پخش، انتشار، مجوز، دادههای کاربران و وابستگیهای بیرونی را ثبت کنید.
- توافق بازیابی: برای هر دسته، RPO، RTO، دامنه حادثه و حداقل خدمت قابل قبول تعیین کنید.
- HA داخلی: نقاط تکخرابی را رفع و استقلال واقعی برق، شبکه و ذخیرهسازی را بررسی کنید.
- آمادهسازی سایت دوم: زیرساخت نسخهدار، انتقال داده، دسترسی کلید و اعتبارسنجی Asset را پیاده کنید.
- دستورالعمل بحران: مسئول اعلام حادثه، ترتیب بازیابی، Fencing، انتقال ترافیک، اعتبارسنجی و Failback را بنویسید.
- آزمون و بازبینی: Restore و Failover را با بار نماینده اجرا و پس از تغییرات مهم تکرار کنید.
برای برآورد هزینه پایداری و Disaster Recovery در VOD، فقط ماشینهای آمادهبهکار را حساب نکنید؛ ذخیره نسخهها، انتقال بین سایتها، بازیابی آرشیو، لایسنس، ترافیک مانور و زمان تیم عملیات نیز سهم دارند. کاهش RTO معمولاً نیازمند آمادهبودن بیشتر اجزا و حفظ مهارت عملیاتی است.
سؤالات متداول
آیا داشتن دو سرور برای High Availability در VOD کافی است؟
خیر. استقلال دامنه خرابی، Load Balancer، ذخیرهسازی، پایگاه داده، شبکه و سرویس مجوز نیز اهمیت دارند. دو سرور با یک وابستگی مشترک میتوانند همزمان از دسترس خارج شوند.
آیا CDN جای Disaster Recovery را میگیرد؟
خیر. کش فقط بخشی از تحویل محتوا را پوشش میدهد. محتوای کشنشده، احراز مجوز، کاتالوگ و دادههای مدیریتی همچنان به معماری بازیابی نیاز دارند.
RPO و RTO مناسب برای VOD چقدر است؟
عدد واحدی وجود ندارد. هدف باید برای نوع داده و جریان کاری تعیین شود و با مانور واقعی اثبات شود. تحمل توقف انتشار جدید ممکن است با تحمل توقف پخش کاربران متفاوت باشد.
آیا Active-Active به معنی ازدستنرفتن هیچ دادهای است؟
خیر. نتیجه به روش تکثیر، مدل نوشتن، تأخیر همگامسازی و کنترل تعارض بستگی دارد. چند سایت فعال بدون طراحی سازگاری حتی میتوانند بازیابی را پیچیدهتر کنند.
مهمترین آزمون پایداری و Disaster Recovery در VOD چیست؟
بازیابی یک مسیر کامل و مجاز پخش از سایت جایگزین، همراه با سنجش تازگی داده و تحمل بار. در کنار آن، بازیابی از نسخه پشتیبان برای خطای انسانی یا فساد داده باید مستقلاً آزمایش شود.
جمعبندی: پایداری و Disaster Recovery در VOD حاصل هماهنگی معماری، داده و عملیات است. مسیر پخش را از پردازش جدا کنید، اهداف بازیابی را برای هر خدمت مشخص کنید و آمادهبودن سایت دوم را با پخش واقعی، Restore و مانور ظرفیت اثبات کنید. برنامهای که فقط روی کاغذ وجود دارد، تضمین بازیابی نیست.